
개요
지난 글에서는 Agentic RAG에 조사 단계와 작성 단계 개선을 적용해 All Evidence를 0.683에서 0.825로 상승시켰고 Correctness는 0.881에서 0.925로 상승시켰습니다. 다만 지난 글의 수치는 모두 재인덱싱 이전 데이터로 측정한 결과였습니다.
그 무렵 인덱싱 LLM 교체와 함께 누적된 검색 품질 문제를 해결하기 위해 전체 문서를 다시 인덱싱했습니다. 재인덱싱 직후 단일 검색 지표는 분명히 상승했지만 정작 Agentic RAG의 Correctness는 거의 변하지 않았고 일부 문항은 오히려 하락했습니다. 원인을 탐색하면서 청킹 과정에서 본문 19.9만 자가 누락되는 버그 두 건과 첨부파일 전용 엔티티의 권한 누락 버그를 발견했습니다.
이번 글에서는 인덱싱 파이프라인을 개편한 과정과 청킹 버그를 디버깅해 해결한 과정을 정리합니다. 마지막에는 재인덱싱 이전과 이후를 같은 조건에서 비교해 최종 성능 중 재인덱싱이 차지하는 부분이 얼마인지도 분리해 측정하겠습니다.
기존 인덱싱의 네 가지 문제
1. 인덱싱 모델 교체와 엔티티 이름 분열
인덱싱 LLM을 gpt-4o-mini에서 gpt-6-luna로 교체하자 문서 요약과 청크 문맥 설명의 품질이 높아졌고, 엔티티 추출 정확도 역시 함께 개선되었습니다.
반면 지식 그래프에는 같은 대상이 서로 다른 이름으로 분산되는 문제가 심해졌습니다.
엔티티 추출은 청크마다 별도로 LLM을 호출해 수행합니다. 이 때문에 같은 대상이라도 gpt-4.1-mini / GPT-4.1-mini / GPT-4.1-Mini처럼 표기 요소(대소문자 / 하이픈 / 공백)만 달라 다른 이름으로 추출되는 경우가 많습니다.
지식 그래프는 이름이 정확히 일치할 때만 같은 노드로 병합하므로 표기가 조금만 달라도 별개 노드가 생성됩니다.
이는 같은 대상이더라도 여러 노드로 분산된 그래프로 인해 출처 청크도 각 노드로 나뉘는 문제의 원인이 됩니다. 이 경우 그래프 탐색 시 한쪽 표기에 연결된 문서를 함께 찾지 못해 검색 누락이 발생합니다.
실제로 운영 중인 문서 공간의 그래프를 점검한 결과 이러한 표기 분열 묶음이 3,000개 이상 누적되어 있었습니다.
2. 청크의 문서 위치 누락과 허브 노드 문제
전체 청크의 약 35%에는 상위 문서 경로와 문서 제목이 누락되어 있었습니다. 제목 헤더에 HTML 태그가 포함되어 있거나 본문 앞부분에서 경로가 누락된 문서들이 원인이었습니다. 이처럼 위치 정보가 누락되면 사용자가 특정 폴더나 문서를 지목해 질문할 때 본문에 해당 이름이 직접 포함되지 않은 청크는 상위 검색 결과에 포함되지 않습니다.
단순히 모든 청크 앞에 상위 페이지 경로를 추가하는 방식도 시험했지만 이번에는 그래프 쪽에서 역효과가 나타났습니다.
예를 들어 이미지 서비스 폴더 아래의 모든 문서 본문에 이미지 서비스라는 단어가 반복되면 LLM이 매 문서에서 이를 엔티티로 추출합니다. 그 결과 모든 관계가 상위 문서 이름 하나에 집중되는 허브 노드가 생성됩니다.
이 노드가 수백 개 문서와 연결되면 그래프 탐색 시 무관한 하위 문서들의 관계까지 한꺼번에 반환되어 정작 필요한 세부 연결을 찾기 어려워집니다.
3. 표 정렬 공백이 검색 발췌를 차지하는 문제
마크다운 변환기는 표의 열을 맞추려고 칸마다 공백을 채웁니다. 전체 토큰 수 기준으로 패딩 공백 제거 전후 차이는 약 4%에 불과해 임베딩 비용에는 거의 영향이 없었지만, 검색 도구가 LLM에게 반환하는 1,000자 발췌에서는 앞부분이 공백 문자로 채워져 정작 주요 내용이 잘리는 문제가 발생했습니다. 결국 에이전트가 발췌만 보고 핵심 수치를 확인하지 못해 불필요한 후속 검색을 반복하거나 근거를 누락하는 원인이 됩니다.
4. 이전 OCR 품질과 이미지 해시 캐시
인덱싱 LLM을 교체하면서 이미지 설명을 생성하는 OCR 성능 역시 gpt-6-luna가 기존 gpt-4o-mini보다 나을 것으로 판단해 사전 검증을 진행했습니다.
기존 캐시에서 표본 이미지 20장을 뽑아 블라인드 LLM-as-a-Judge 비교를 수행했습니다.
판정 모델에는 모델명을 가린 채 원본 이미지와 두 모델이 만든 OCR 설명을 함께 전달했습니다.
판정 기준은 두 가지였습니다.
- 오독 오류: 이미지에 없는 내용을 잘못 읽거나 지어낸 경우
- 핵심 정보 누락: 이미지 안의 주요 텍스트나 수치를 빠뜨린 경우
비교 결과 전체 20장 중 75%에서 gpt-6-luna가 더 나은 설명으로 판정되었습니다.
기존 모델이 앞선 비율은 15%였고 나머지 10%는 동등 수준이었습니다.
세부 오류를 집계하면 오독과 환각은 30건에서 19건으로 37% 줄었고 누락한 핵심 정보는 33건에서 3건으로 91% 감소했습니다.
이 결과를 바탕으로 OCR 모델 역시 gpt-6-luna로 교체하기로 결정했습니다.
다만 기존 OCR 결과는 이미지 내용의 해시를 기준으로 캐시되어 있었으므로 단순 재인덱싱만으로는 이전 모델이 생성한 낮은 품질의 설명이 그대로 재사용되는 구조였습니다. 화면 캡처나 구조도 속 설명이 OCR 단계에서 누락되면 텍스트 검색과 답변 모두에서 해당 근거를 찾을 수 없습니다. 따라서 캐시 초기화도 함께 필요했습니다.
인덱싱 변경 사항과 배치 재인덱싱
위 네 가지 문제를 해결하기 위해 인덱싱 파이프라인을 다섯 단계로 정비했습니다.
엔티티 이름 표기 통일
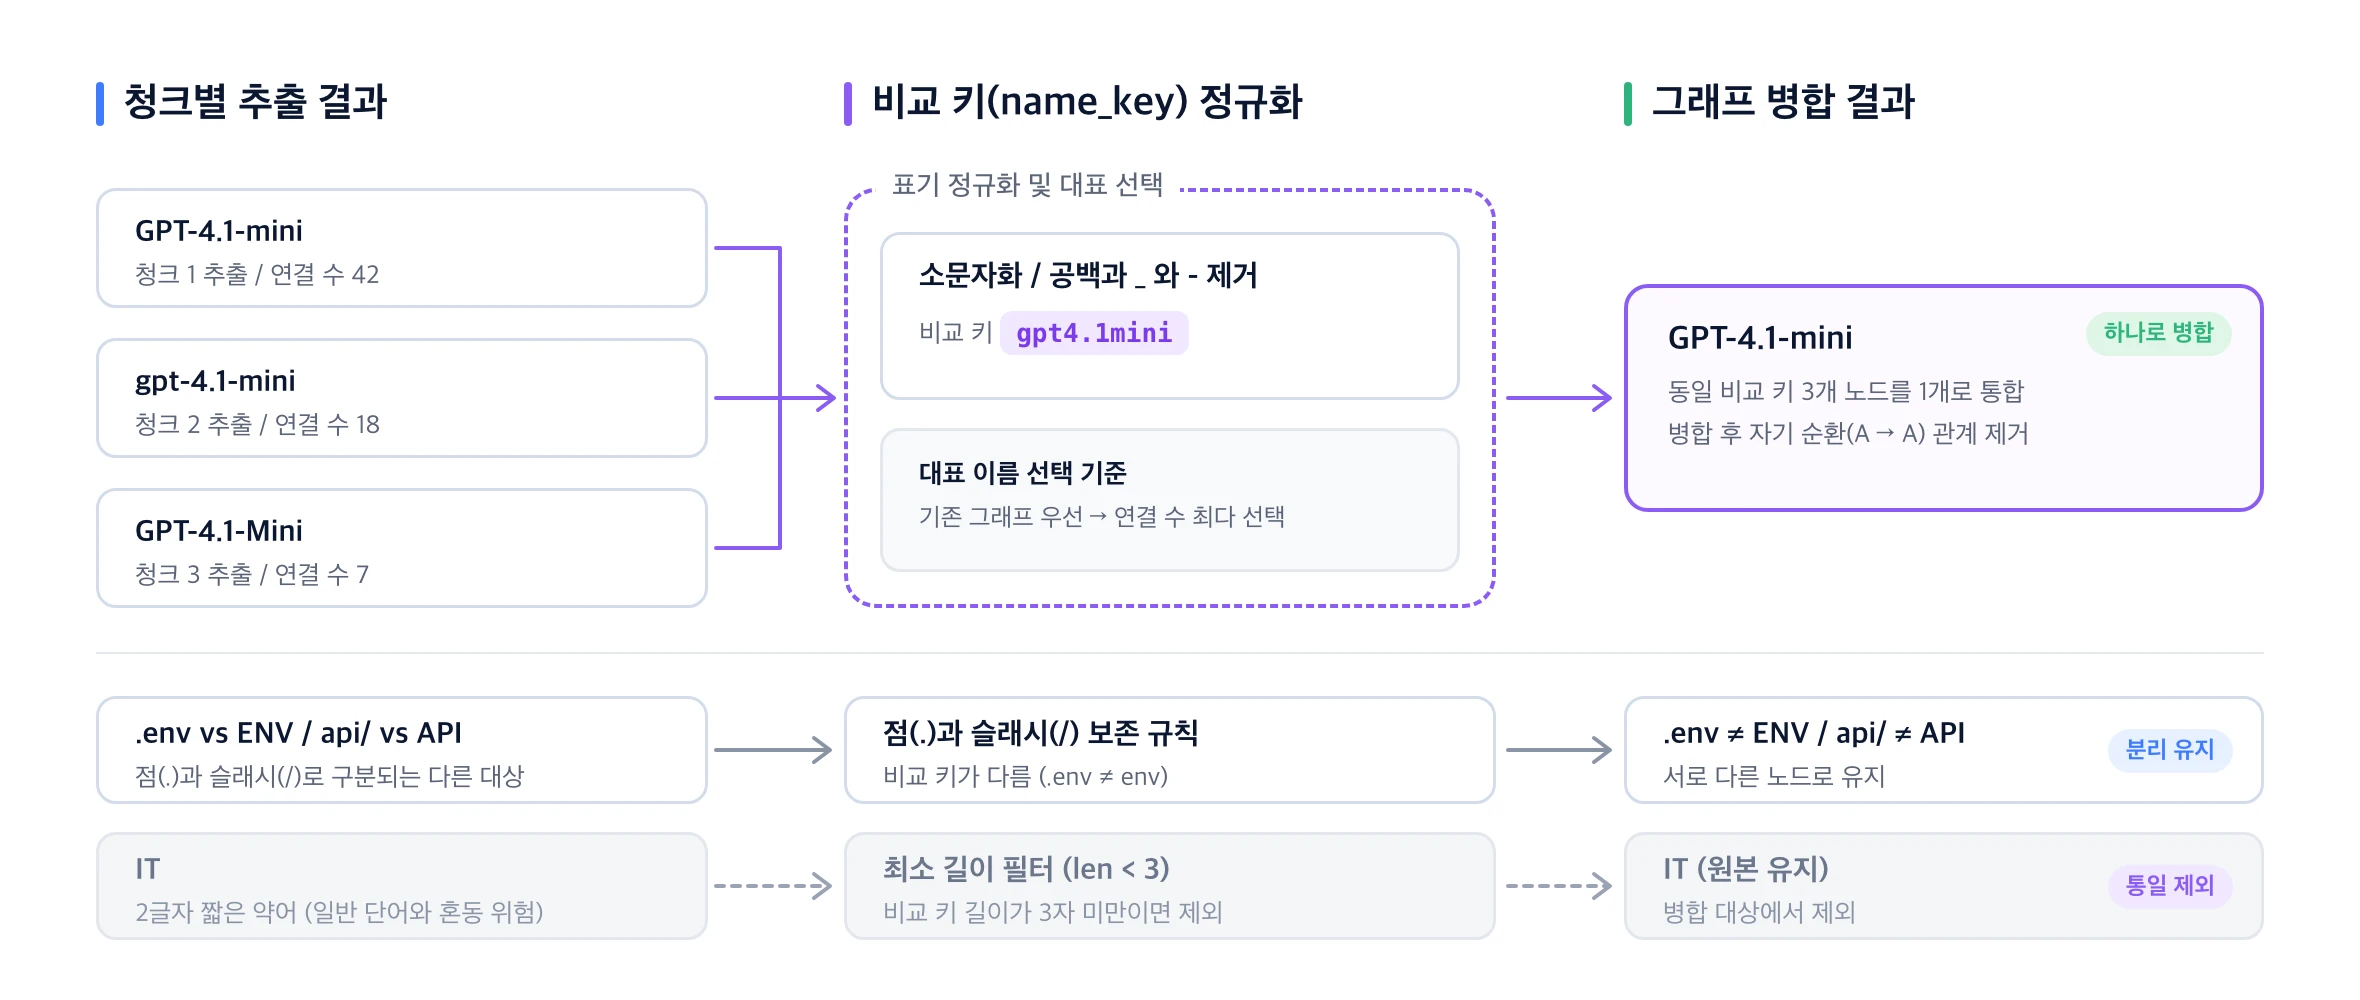
청크별 추출 결과를 그래프에 병합하기 직전에 표기 차이(대소문자 / 공백 / 구분자)를 정규화하는 비교 키를 적용했습니다.
1
2
3
4
5
6
7
8
_SEP = re.compile(r"[\s_\-·]+")
_MIN_KEY_LEN = 3


def name_key(name: str) -> str:
    """같은 대상 판별용 비교 키."""
    k = unicodedata.normalize("NFKC", name).casefold()
    return _SEP.sub("", k)
정규화 대상 구분자(공백 / 밑줄 / 하이픈)는 제거하되 점(.)과 슬래시(/)는 남겼습니다.
점이나 슬래시 유무에 따라 .env와 ENV가 구분되고 api/와 API도 서로 다른 대상을 가리키기 때문입니다.
4.1과 41 같은 버전 표기도 마찬가지입니다.
또한 IT 같은 짧은 약어가 일반 단어와 혼동되지 않도록 키 길이가 3자 미만이면 통일 대상에서 제외했습니다.
같은 비교 키에 여러 이름이 해당할 때 대표 이름을 정하는 기준은 두 단계입니다.
- 기존 그래프에 이미 존재하는 이름이 있으면 그 표기를 우선합니다.
- 기존 그래프에 없다면 연결 수(degree)가 가장 많은 표기를 선택합니다.
대표 이름이 같아져 출발 노드와 도착 노드가 동일해진 자기 순환 관계는 제거했습니다. 기존 그래프에 쌓여 있던 분열 묶음은 LLM을 다시 호출하지 않고 임베딩만 재생성해 총 3,306묶음을 모두 병합했습니다.
문서 위치: 줄 추가와 추출 직전 제거
상위 경로가 검색에는 포함되되 엔티티로는 추출되지 않도록 청크 앞부분에 전용 헤더 줄을 두고 추출 직전에만 제거하는 방식을 적용했습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
DOC_LOCATION_PREFIX = "문서 위치: "


def doc_location_line(ancestors: Sequence[str]) -> str:
    """상위 페이지 경로 줄. 상위 페이지가 없으면 빈 문자열."""
    return DOC_LOCATION_PREFIX + " > ".join(ancestors) if ancestors else ""


def strip_doc_location(text: str) -> str:
    """청크 맨 앞의 `문서 위치:` 줄을 지운다(엔티티 추출 입력용)."""
    if not text.startswith(DOC_LOCATION_PREFIX):
        return text
    nl = text.find("\n")
    return "" if nl < 0 else text[nl + 1:].lstrip("\n")
이 구조에서는 문서 위치: 상위 > 경로 문자열이 벡터와 BM25 인덱스에 그대로 저장되므로 경로 지목 질의에서 해당 문서가 바로 검색됩니다.
반면 엔티티 추출 단계에서는 첫 줄을 제거하는 전처리로 상위 페이지 이름이 허브 노드로 사용되지 않습니다.
실제로 재인덱싱 후 검증한 결과 문서 청크 5,741개 중 5,687개가 문서 위치: 줄로 시작했고 상위 페이지 이름이 엔티티로 추출된 비율은 2,507개 중 33개(1.3%)로 낮아졌습니다.
공백 정리와 OCR 캐시 초기화
줄 끝 공백과 표 정렬용 연속 패딩을 한 칸으로 줄였습니다.
표 구분선 역시 --- 형태로 축약해 청킹과 검색 발췌 양쪽에 공통 적용했습니다.
다만 코드 블록 내부의 들여쓰기는 문법적 의미를 가지므로 변경하지 않았습니다.
OCR 캐시 테이블은 기존 행(이미지 1,489건 / PDF 첨부파일 27건)을 별도 테이블로 백업한 뒤 비워 gpt-6-luna가 이미지를 다시 읽게 했습니다.
배치 재인덱싱 전략
기존 강제 재인덱싱 방식은 문서를 하나씩 삭제하고 공유 엔티티 요약을 다시 계산한 뒤 재삽입하는 구조입니다. 문서 3건으로 시험한 결과 15분 만에 0.34달러가 소요되었습니다. 이 속도를 전체 11,512청크에 대입하면 약 96시간과 130달러가 예상되었습니다.
그래서 운영 DB를 로컬 환경으로 복제한 뒤 대상 워크스페이스를 비우고 새 코드로 100개 문서씩 일괄 인덱싱하는 방식을 선택했습니다. 삭제와 재요약 비용이 제외되면서 실제 소요 시간은 7시간 47분으로 줄었고 비용은 22.03달러로 마무리되었습니다.
| 항목 | 재인덱싱 전 | 재인덱싱 후 | 변화 |
|---|---|---|---|
| 문서 수 | 1,022 | 971 | −51 (빈 문서 제외) |
| 청크 수 | 11,381 | 10,307 | −1,074 (공백 정리 효과) |
| 엔티티 수 | 43,770 | 74,197 | +30,427 |
| 관계 수 | 60,407 | 141,059 | +80,652 |
문서 수가 줄어든 이유는 Confluence가 폴더 기능을 지원하지 않던 시기에 하위 문서를 묶는 폴더 용도로 생성한 빈 페이지들 때문입니다. 기존에는 본문이 없어도 상위 경로 줄이 포함되어 빈 청크로 색인되었지만 이번 재인덱싱에서는 경로 줄만 제거하고 내용이 없는 문서를 제외하면서 이러한 폴더형 빈 페이지 52개가 제외되었습니다.
결과적으로 표기 분열을 병합해 중복 엔티티를 줄였는데도 전체 엔티티와 관계 수는 오히려 약 두 배로 늘었습니다.
모델을 gpt-6-luna로 교체하면서 기존보다 더 다양한 엔티티와 관계가 추출되었기 때문입니다.
그럼에도 질의 1회당 비용(약 0.72달러)과 응답 시간 중앙값(33~35초)에는 변화가 없었습니다.
재인덱싱 직후 발생한 버그
1. 첨부파일 전용 엔티티의 권한 누락
재인덱싱이 끝난 뒤 정합성을 점검하자 엔티티 31,803개와 관계 70,570개에 권한(ACL) 필드가 누락되어 있음을 발견했습니다.
기존 구조에서는 일반 페이지 권한 기록 단계와 첨부파일 권한 기록 단계의 역할이 분리되어 있었습니다. 첨부파일 권한 기록 단계는 첨부파일 청크에만 부모 페이지의 권한을 기록하고 엔티티나 관계 노드는 직접 수정하지 않습니다. 대신 뒤이어 실행되는 일반 페이지 권한 기록 단계가 워크스페이스 전체 청크의 권한 정보를 읽은 뒤 각 엔티티와 관계가 연결된 출처 청크들의 권한 합집합을 계산해 기록하는 구조였습니다.
원인은 일반 페이지 권한 기록 단계가 업데이트 대상을 고를 때 일반 페이지 ID만 비교 집합에 포함했기 때문입니다. 일반 페이지와 함께 언급된 엔티티는 일반 페이지 ID 덕분에 선택되었지만, 첨부파일에서만 단독으로 추출된 엔티티는 출처 청크의 기여 문서가 전부 첨부파일 ID이므로 선택 조건에서 누락되었습니다. 기존 운영 환경에서는 이런 첨부파일 전용 엔티티가 8개뿐이라 문제가 드러나지 않았으나 전체 문서를 비우고 새로 색인하면서 3만 개 이상으로 확대되었습니다. 검색 필터는 권한 필드가 없는 항목을 전부 제외하므로 첨부파일 내용으로 이어지는 그래프 탐색 경로가 차단되는 버그였습니다.
이를 해결하기 위해 Confluence API 조회 대상이나 청크 쓰기 범위는 그대로 유지했습니다. 대신 그래프 대상(엔티티 / 관계 / Neo4j 노드)을 고르는 선택 집합에만 이번에 색인한 첨부파일 문서 ID를 합집합으로 추가했습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# 수정 전: 일반 페이지 ID만 선택 집합에 포함
page_id_set = set(page_ids)

# 수정 후: 첨부파일 ID를 선택 집합에 추가 (권한 조회 대상 page_ids는 그대로 유지)
async def _apply_acl_for_pages(
    page_ids: list[str], rag: LightRAG, *, notify=None, attachment_ids: list[str] | tuple = ()
) -> None:
    ...
    page_id_set = set(page_ids) | {a for a in attachment_ids if a}

    # 엔티티와 관계 선택 시 첨부파일만 기여한 항목도 함께 수집한다
    for p in batch:
        contributing = _all_pages_from_src((p.payload or {}).get("source_id"))
        if any(pid in page_id_set for pid in contributing):
            entity_pages[p.id] = contributing
2. 단일 검색은 상승했지만 Agentic 점수는 정체
권한 보정을 마친 뒤 4편에서 구축한 80문항 평가셋으로 재인덱싱 전후를 비교했습니다. 먼저 한 번만 검색하는 단일 통합 검색(조건별 5회 반복)에서는 성능이 뚜렷하게 상승했습니다.
| 지표 | 재인덱싱 전 | 재인덱싱 후 |
|---|---|---|
| All Evidence@10 (주 지표) | 0.273 (0.250~0.287) | 0.318 (0.300~0.338) |
| All Docs@10 | 0.595 (0.588~0.613) | 0.635 (0.625~0.650) |
location_hint 태그 (14문항) |
0.200 | 0.457 |
variant_spelling 태그 (16문항) |
0.250 | 0.175 |
다섯 차례 측정 범위가 서로 겹치지 않을 정도로 단일 검색 품질이 개선되었습니다.
특히 상위 페이지 이름으로 문서를 지목하는 location_hint 문항은 0.200에서 0.457로 두 배 이상 상승했습니다.
반면 variant_spelling 태그는 0.250에서 0.175로 하락했습니다. 내용을 확인한 결과 16문항 중 14문항은 전후 결과가 같았습니다.
나머지 한 문항의 경우 청킹이 재분할되면서 필요한 두 번째 청크의 순위가 7위에서 11~12위로 낮아져 상위 10개 기준에서 제외되는 것이 원인이었습니다.
더 자세히 살펴보니, 질문 자체가 영문 표기 변형이 아니라 Kubernetes를 쿠버네티스로 표기한 한글 음차 질문이므로 엔티티 이름 통일 기능과는 무관한 이유로 점수가 하락한 것입니다.
같은 16문항을 Agentic 검색으로 측정했을 때는 All Evidence가 오히려 0.583에서 0.750으로 상승했습니다.
의문이 남는 지점은 개선 적용 전 초기 Agentic RAG의 전체 평가 점수였습니다.
| 지표 (각 3회 반복) | 재인덱싱 전 | 재인덱싱 후 |
|---|---|---|
| All Evidence | 0.683 (0.650~0.713) | 0.717 (0.713~0.725) |
| Correctness | 0.881 (0.869~0.894) | 0.877 (0.863~0.900) |
| Faithfulness | 0.860 | 0.885 |
검색 근거 확보율(All Evidence)은 상승했지만 답변 정확도(Correctness)는 오르지 않았고, 재인덱싱 전에는 매번 맞히던 문항 일부가 실패했습니다.
그래서 오답 문항을 점검하던 중 평가셋의 정답 근거 문장 348개 중 7개가 새로 인덱싱한 청크 어디에도 존재하지 않는 현상을 발견했습니다.
청크 누락 버그
처음에는 공백 정리 때문에 청크 경계가 이동하면서 근거 문장이 두 청크에 걸쳐 분할되었다고 추측했습니다. 그러나 재인덱싱 전 스냅샷의 청크를 별도로 복원해 같은 문서의 청크를 1:1로 비교한 결과 경계 문제가 아니었습니다. 원문 본문 자체가 누락되고 있었습니다.
버그 1: 이미지 설명 속 깨진 코드 블록 기호
원인은 새 OCR 모델(gpt-6-luna)과 이미지 설명 래퍼의 조합에 있었습니다.
gpt-6-luna는 코드가 찍힌 스크린샷을 설명할 때 본문에 마크다운 코드 블록(```python ... ```)을 그대로 포함해 반환했습니다.
반면 기존 추출 코드는 이미지 설명을 본문에 삽입할 때 한 줄 형식으로 붙여 감싸고 있었습니다.
1
2
3
4
[이미지 설명: ```python
def sync_worker():
    return True
```]
이 문자열이 마크다운 제목 분할기에 전달되면 두 가지 현상이 동시에 일어납니다.
먼저 여는 기호 ```python 앞에는 [이미지 설명: 가 붙어 있어 줄 맨 앞이 아니므로 코드 블록 시작으로 인식되지 않습니다.
반대로 닫는 기호 ```]는 줄 맨 앞에서 시작하므로 분할기가 이를 새로운 여는 코드 블록으로 잘못 인식합니다.
분할기는 끝까지 닫히지 않는 코드 블록이 포함되면 그 이후에 이어지는 섹션 본문을 통째로 제외합니다.
결과적으로 깨진 이미지 설명이 등장한 지점 이후부터 문서의 뒷부분 내용이 분할기에 의해 전부 누락됩니다.
원인을 파악한 뒤 전체 문서를 스캔하자 깨진 이미지 설명 형식이 46개 문서에서 발견되었습니다. 이 가운데 일반 문서 14건에서 약 1.5만 자가 누락되었고 CSV 첨부파일 2건에서는 본문의 62%와 69%가 각각 누락되어 있었습니다. 영향 받은 35건에서 누락된 본문을 모두 합치면 약 19.9만 자였습니다.
수정과 3중 방어선
같은 문제가 재발하지 않도록 세 군데를 함께 수정했습니다.
1
2
3
4
5
6
7
8
9
# 1. 이미지 설명에 코드 블록이 포함되면 줄을 분리하고 홀수 펜스를 닫는다
def wrap_image_desc(desc: str) -> str:
    if "```" not in desc and "~~~" not in desc:
        return f"[이미지 설명: {desc}]"
    body = desc.strip("\n")
    fences = _FENCE_LINE_RE.findall(body)
    if len(fences) % 2:
        body += "\n" + fences[-1]
    return f"[이미지 설명:\n{body}\n]"
1
2
3
4
5
6
7
8
9
10
11
# 2. 이미 깨진 형식으로 DB에 저장된 원문도 청킹 전에 줄 단위로 교정한다
_GLUED_FENCE_OPEN_RE = re.compile(r"\[이미지 설명:[ \t]*(?=`{3,}|~{3,})")
_GLUED_FENCE_CLOSE_RE = re.compile(r"(?m)^([ \t]*)(`{3,}|~{3,})([^\w\s`~+#-][^\n]*)$")


def repair_fence_lines(content: str) -> str:
    content = _GLUED_FENCE_OPEN_RE.sub("[이미지 설명:\n", content)
    return _GLUED_FENCE_CLOSE_RE.sub(
        lambda m: f"{m.group(1)}{m.group(2)}\n{m.group(1)}{m.group(3)}",
        content,
    )
여기에 원인과 무관하게 제목 분할기의 본문 유실 자체를 막는 안전장치를 추가했습니다. 제목 분할을 수행한 뒤 원문 본문 줄이 한 글자라도 빠졌는지 검사합니다. 누락이 감지되면 경고 로그를 남긴 채 해당 문서의 제목 분할을 건너뛰고 일반 분할만 적용합니다. 섹션 경로 메타데이터를 포기하더라도 본문이 유실되지 않게 만드는 방어선입니다.
버그 2: 큰 코드 블록 분할 시 청크 유실
버그 1을 수정한 뒤 영향 문서 35건을 다시 색인하자 19.9만 자 중 19.3만 자가 복구되었습니다. 그런데 평가 결과 CSV 첨부파일 하나에서 여전히 6천 자가 누락되고 있었습니다.
단계별 변환 결과를 출력해 확인한 결과 앞선 세 단계(공백 정리 / 기호 수리 / 제목 분할)까지는 6천 자가 모두 남아 있었습니다. 마지막 단계인 1,024토큰 초과 코드 블록 분할기를 통과하는 순간 해당 줄이 유실되고 있었습니다.
원인은 CSV 표의 셀 안에 우연히 코드 블록 기호 ```가 들어가 있었고 청커가 이를 코드 블록으로 잘못 인식한 데 있었습니다.
문제가 된 CSV 행은 줄 맨 앞이 ```로 시작한 뒤 같은 줄에 2,000~4,000자 분량의 셀 본문이 한 줄로 이어지는 형태였습니다.
원래 CommonMark 표준상 닫는 기호 뒤에 다른 텍스트가 이어지면 코드 블록 기호로 보지 않습니다.
하지만 청커는 줄 맨 앞이 ```로 시작하는지만 검사했기 때문에 이 일반 표 행들 사이를 하나의 거대한 코드 블록으로 묶었습니다.
이렇게 잘못 묶인 구간이 1,024토큰을 넘어가자 큰 코드 블록 분할기가 실행되면서 본문 유실이 발생했습니다.
정상적인 코드 블록은 첫 줄(```python)과 마지막 줄(```)에 코드가 없고 문법 기호만 있습니다.
그래서 분할기는 조각마다 여닫이 기호를 새로 붙이기 전에 원래 첫 줄과 마지막 줄을 본문에서 먼저 제외하고 중간 줄만 나눕니다.
- 여는 줄: 기호와 첫 단어(언어 표시)만 추출해 새 시작 기호로 삼고 같은 줄 뒤의 나머지 텍스트를 버림
- 닫는 줄: 마지막 줄 전체를 본문에서 제외한 뒤 새 끝 기호(
```)만 다시 붙임
예를 들어 마크다운 표에서 우연히 ```로 시작하는 긴 행이 두 번 등장하고 그 사이 분량이 1,024토큰을 넘었다고 가정해 보겠습니다.
1
2
3
``` | 첫 번째 행의 본문 설명이 길게 이어지는 구간...
... (중간 1,024토큰 이상) ...
``` | 마지막으로 타임아웃을 30초로 조정하는 상세 가이드... (약 3,000자)
분할기가 이 구간을 코드 블록으로 처리하면 여는 줄에서는 첫 단어 | 뒤의 설명이 제거됩니다.
닫는 줄에서는 마지막 줄 전체가 종료 기호 줄로 간주되어 전부 제거됩니다.
결국 분할된 청크에는 코드 블록 기호만 남고 각 줄 뒤에 붙어 있던 약 3,000자 분량의 본문이 유실됩니다.
1
2
3
```|
... (중간 구간) ...
```
파서 판정 규칙을 표준에 맞추어 전면 교체하면 기존 문서 청크 경계가 크게 달라지므로 유실만 막는 최소 수정을 선택했습니다.
1
2
3
4
5
6
7
8
9
# 마지막 줄은 기호 뒤에 다른 문자가 없을 때만 닫는 펜스로 제외한다
mc = _FENCE_OPEN_RE.match(lines[-1]) if len(lines) >= 2 else None
has_close = bool(mc) and not lines[-1][mc.end("marker"):].strip()
inner = lines[1:-1] if has_close else lines[1:]

# 여는 줄에서 언어 표시 뒤 남은 내용은 제거하지 않고 첫 조각 본문 앞에 추가한다
tail = lines[0][m.end():]
if tail.strip():
    inner = [tail] + inner
회귀 검증
수정 후 전체 문서 1,140개를 수정 전후 청커로 각각 분할해 글자 단위로 대조했습니다.
| 검증 대상 | 수정 전 → 수정 후 |
|---|---|
| 평가 결과 CSV 첨부파일 | 누락 본문 줄 2 → 0 (청크 172 → 176) |
| 닫히지 않은 펜스 포함 문서 1건 | 유실되던 언어 표시 7자 복구 |
| 나머지 1,138개 문서 | 모든 청크가 글자 하나까지 동일 |
검증 결과 전체 코퍼스에서 본문이 10% 이상 누락된 문서는 0건이었고 평가 근거 348개도 전부 포함되어 있었습니다.
최종 측정과 재인덱싱 부분 분리 검증
청킹 본문 누락 버그 수정까지 모두 반영한 뒤 지난 글에서 구현한 Agentic 개선 다섯 가지(후속 검색 원칙 / 이웃 청크 자동 추가 / 하위 근거 제외 / 인계 메모 / 문서 날짜)를 적용하고 평가셋 80문항을 다시 측정했습니다. 재인덱싱 자체의 순수한 기여도를 구분해 확인하기 위해 두 RAG 경로를 각각 따로 묶어 동일한 질의 조건에서 재인덱싱 전후를 비교했습니다.
1. 초기 단일 RAG 비교 (재인덱싱 전 vs 후)
4편과 5편에서 기준선으로 사용한 단일 통합 검색 경로에서 재인덱싱 전후를 각각 5회씩 측정했습니다. (참고: 단일 통합 검색은 버그 1과 버그 2 수정 전인 재인덱싱 직후 시점에 측정한 결과입니다.)
| 지표 (각 5회 평균) | 재인덱싱 전 | 재인덱싱 후 | 차이 |
|---|---|---|---|
| All Evidence@10 (주 지표) | 0.273 (0.250~0.287) | 0.318 (0.300~0.338) | +0.045 |
| All Docs@10 | 0.595 (0.588~0.613) | 0.635 (0.625~0.650) | +0.040 |
| Evidence Recall@10 | 0.604 | 0.632 | +0.028 |
유형 및 태그별 All Evidence@10 점수는 다음과 같습니다.
| 구분 | 문항 | 재인덱싱 전 | 재인덱싱 후 | 차이 |
|---|---|---|---|---|
| 전체 | 80 | 0.273 | 0.318 | +0.045 |
단일 (single) |
10 | 0.900 | 0.900 (MRR 1.000) | 0.000 |
연쇄 (bridge) |
16 | 0.100 | 0.125 | +0.025 |
비교 (comparison) |
11 | 0.182 | 0.218 | +0.036 |
열거/집계 (aggregation) |
9 | 0.267 | 0.200 | −0.067 |
수치 계산 (numeric) |
9 | 0.244 | 0.467 | +0.222 |
규칙 적용 (rule_application) |
9 | 0.267 | 0.333 | +0.067 |
원인 진단 (causal) |
9 | 0.133 | 0.222 | +0.089 |
변경/시점 추적 (temporal) |
7 | 0.143 | 0.143 | 0.000 |
태그 location_hint (상위 경로 지목) |
14 | 0.200 | 0.457 | +0.257 |
한 번의 검색 결과만 평가하는 초기 단일 RAG에서는 인덱스 개선이 곧바로 수치로 이어집니다.
전체 All Evidence@10이 0.273에서 0.318로 다섯 차례 측정 범위가 겹치지 않을 만큼 상승했고 그중에서도 location_hint가 0.200에서 0.457(+0.257)로 두 배 이상 상승했으며 수치 계산 역시 0.244에서 0.467(+0.222)로 크게 올랐습니다.
단일 유형의 첫 정답 순위(MRR)도 0.935에서 1.000으로 만점에 도달해 단순 질의나 위치 지목 질의를 매번 비용이 높은 Agentic 루프로 처리하지 않고 단일 검색 경로로 분기할 기반을 마련했습니다.
2. Agentic RAG 비교 (5편 최종 vs 6편 최종)
Agentic RAG에서는 5편에서 완성한 개선 다섯 가지를 동일하게 적용한 상태에서 재인덱싱 전(5편 최종)과 재인덱싱 및 버그 수정 후(6편 최종)를 각각 2회씩 측정해 비교했습니다.
| 지표 (각 2회 평균) | 5편 최종 (재인덱싱 전) | 6편 최종 (재인덱싱 후) | 차이 |
|---|---|---|---|
| Correctness | 0.925 | 0.934 | +0.009 |
| Faithfulness | 0.959 | 0.950 | −0.009 |
| All Evidence | 0.825 | 0.850 | +0.025 |
| 실행 비용 (80문항) | 0.69달러 | 0.74달러 | +0.05달러 |
문항 단위로 짝지어 부호 검정을 수행한 결과 Correctness는 상승 10문항 대 하락 9문항(p=1.0)으로 전체 평균 차이는 통계적으로 유의하지 않았습니다. Agentic 루프에서는 첫 검색에 포함되지 않은 문서를 후속 검색으로 조회하고 이웃 청크까지 자동으로 추가하므로 인덱스 자체의 품질 차이를 탐색 단계에서 상당 부분 상쇄하기 때문입니다.
하지만 유형 및 태그별 Correctness로 나누어 보면 재인덱싱 효과가 드러나는 부분이 분명히 확인됩니다.
| 구분 | 문항 | 5편 최종 (재인덱싱 전) | 6편 최종 (재인덱싱 후) | 차이 |
|---|---|---|---|---|
| 전체 | 80 | 0.925 | 0.934 | +0.009 |
단일 (single) |
10 | 1.000 | 1.000 | 0.000 |
연쇄 (bridge) |
16 | 0.953 | 0.906 | −0.047 |
비교 (comparison) |
11 | 0.841 | 0.932 | +0.091 |
열거/집계 (aggregation) |
9 | 0.917 | 0.972 | +0.056 |
수치 계산 (numeric) |
9 | 0.972 | 0.944 | −0.028 |
규칙 적용 (rule_application) |
9 | 0.889 | 0.917 | +0.028 |
원인 진단 (causal) |
9 | 0.944 | 0.889 | −0.056 |
변경/시점 추적 (temporal) |
7 | 0.857 | 0.929 | +0.071 |
태그 location_hint (상위 경로 지목) |
14 | 0.911 | 1.000 | +0.089 |
표를 보면 상위 문서 경로 단서와 대조가 필요한 유형에서 재인덱싱 효과가 뚜렷하게 나타납니다.
location_hint전원 정답 달성 (0.911 → 1.000): 상위 페이지 이름을 단서로 포함한 14문항이 상승 4건과 하락 0건으로 모두 만점을 기록했습니다. 청크 앞부분에 추가한문서 위치:줄 덕분에 조사 단계에서 관련 문서가 정확히 검색된 결과입니다.- 비교와 변경/시점 추적의 성능 향상: 5편 최종 시점까지 정체되어 있던 비교 유형이 0.841에서 0.932(+0.091)로 가장 크게 올랐습니다. 변경/시점 추적 역시 0.857에서 0.929(+0.071)로 상승했는데 버그 1 수정으로 본문 유실이 복구된 문항이 정답으로 바뀐 부분이 더해졌기 때문입니다. 열거/집계 역시 0.972까지 올랐습니다.
- 표본 수에 따른 등락 폭: 연쇄(−0.047) / 원인 진단(−0.056) / 수치 계산(−0.028) 유형은 2회 평균 측정에서 소폭 하락했습니다. 각 유형은 7~16문항 규모이므로 1~2건의 회차 간 결과 차이만으로도 평균이 0.03~0.05가량 변합니다. 특히 수치 계산은 버그 1 수정 전 0.889까지 하락했다가 누락 청크 복구 후 0.944로 다시 올랐습니다.
검증을 마친 로컬 인덱싱 결과와 권한 데이터를 운영 DB에 반영했습니다. 이후 로컬 복사 시점 뒤에 수정된 8건의 문서를 증분 인덱싱으로 동기화해 배포를 마쳤습니다.
정리
이번 작업에서는 인덱싱 모델 교체 과정에서 드러난 네 가지 문제(엔티티 분열 / 문서 위치 누락 / 표 공백 발췌 / 이전 OCR 캐시)를 한꺼번에 정비했습니다. 이어 재인덱싱 이후 점수 정체를 탐색하면서 본문 19.9만 자가 누락되던 버그 두 건(이미지 설명 코드 펜스 깨짐 / 코드 블록 분할기 유실)을 찾아내 누락량 0자로 복구했습니다.
인덱스를 변경한 뒤에는 평가셋의 근거 문장이 청크 안에 실제로 남아 있는지 직접 검산해야 합니다. 만약 점수 하락을 청킹 경계 변화의 영향으로만 판단했다면 원문 손실을 모른 채 운영에 반영했을 것입니다. 또한 Agentic RAG가 인덱스의 약점을 보완해 주기는 하지만 비용 최적화를 위해서는 단일 검색 인덱스의 품질 역시 함께 높여야 한다는 사실을 확인했습니다. 결과적으로 이번 재인덱싱으로 단일 검색 RAG의 성능을 높여 간단한 질의는 단일 RAG로 처리하고 복잡한 질의만 Agentic RAG로 라우팅하는 기반을 마련했습니다.
지금까지는 정제된 위키 문서를 중심으로 검색과 에이전트 루프를 다듬었습니다. 다음 글에서는 비정형 텍스트가 가득한 Slack 대화를 원문 그대로 색인하지 않고 지식 노트로 증류해 RAG에 편입한 과정을 정리하겠습니다.