
개요
지난 글에서는 복합 질의를 측정하기 위해 평가셋과 검색 지표를 재구축한 과정을 정리했습니다. 그 평가셋으로 측정한 결과, 질문으로 한 번만 검색하는 단일 검색 RAG는 연쇄 유형의 All Evidence@10이 0.062로 매우 낮았습니다. 사실상 문서 A를 읽어야 문서 B의 이름을 알 수 있는 질문은 거의 답변이 불가능한 수치였습니다.
이 문제를 해결하기 위해 LLM이 검색 결과를 읽고 추가 자료가 필요한지 스스로 판단 후 필요하면 다시 검색하는 Agentic RAG를 도입하게 되었습니다. 이번 글에서는 Agentic RAG의 구조를 먼저 설명하고, 단일 검색 RAG를 베이스라인으로 삼아 초기 Agentic RAG를 비교하겠습니다. 이어서 초기 Agentic RAG에서 발생하는 여러 문제를 분석하고 이를 개선한 과정을 정리하겠습니다. 이 글의 성능 수치는 모두 지난 글의 평가셋 80문항으로 측정한 값입니다.
앞선 두 번의 시도
이 글에서 설명할 구조는 세 번째 구현입니다. 그 전에 총 두 번의 시도가 있었는데, 모두 검색 절차를 코드로 정의하는 방식이었습니다.
- 질문의 복잡도를 먼저 판정하고 복잡한 질문만
질문 분해 → 여러 방향 검색 → 근거 충분 판정 → 부족하면 재질의 → 종합순서로 처리 - 같은 절차를 유지하되 충분한지 판정하는 부분만 LLM의 추론 루프로 교체
첫 번째 시도는 LLM이 첫 검색 직후 근거가 충분하다고 판정하고 너무 일찍 검색을 종료하는 경우가 많았습니다. 또한 “더 검색해도 효과가 없는 상황”을 감지하기 위해 검색 점수에 임계값 0.05를 지정했는데, 로그를 확인해보니 실제로 관측된 최저값이 0.091이었습니다. 이는 검색 효과 판단 장치가 한 번도 동작하지 않았음을 의미했습니다.
두 번째 방식은 응답 시간이 매우 길어지는데, 성능은 단일 RAG와 사실상 차이가 없어 도입을 보류했습니다.
세 번째 구현은 앞의 두 시도와 달리 절차를 코드로 정의하지 않고 LLM이 직접 도구를 선택하게 했습니다.
Agentic RAG 구조
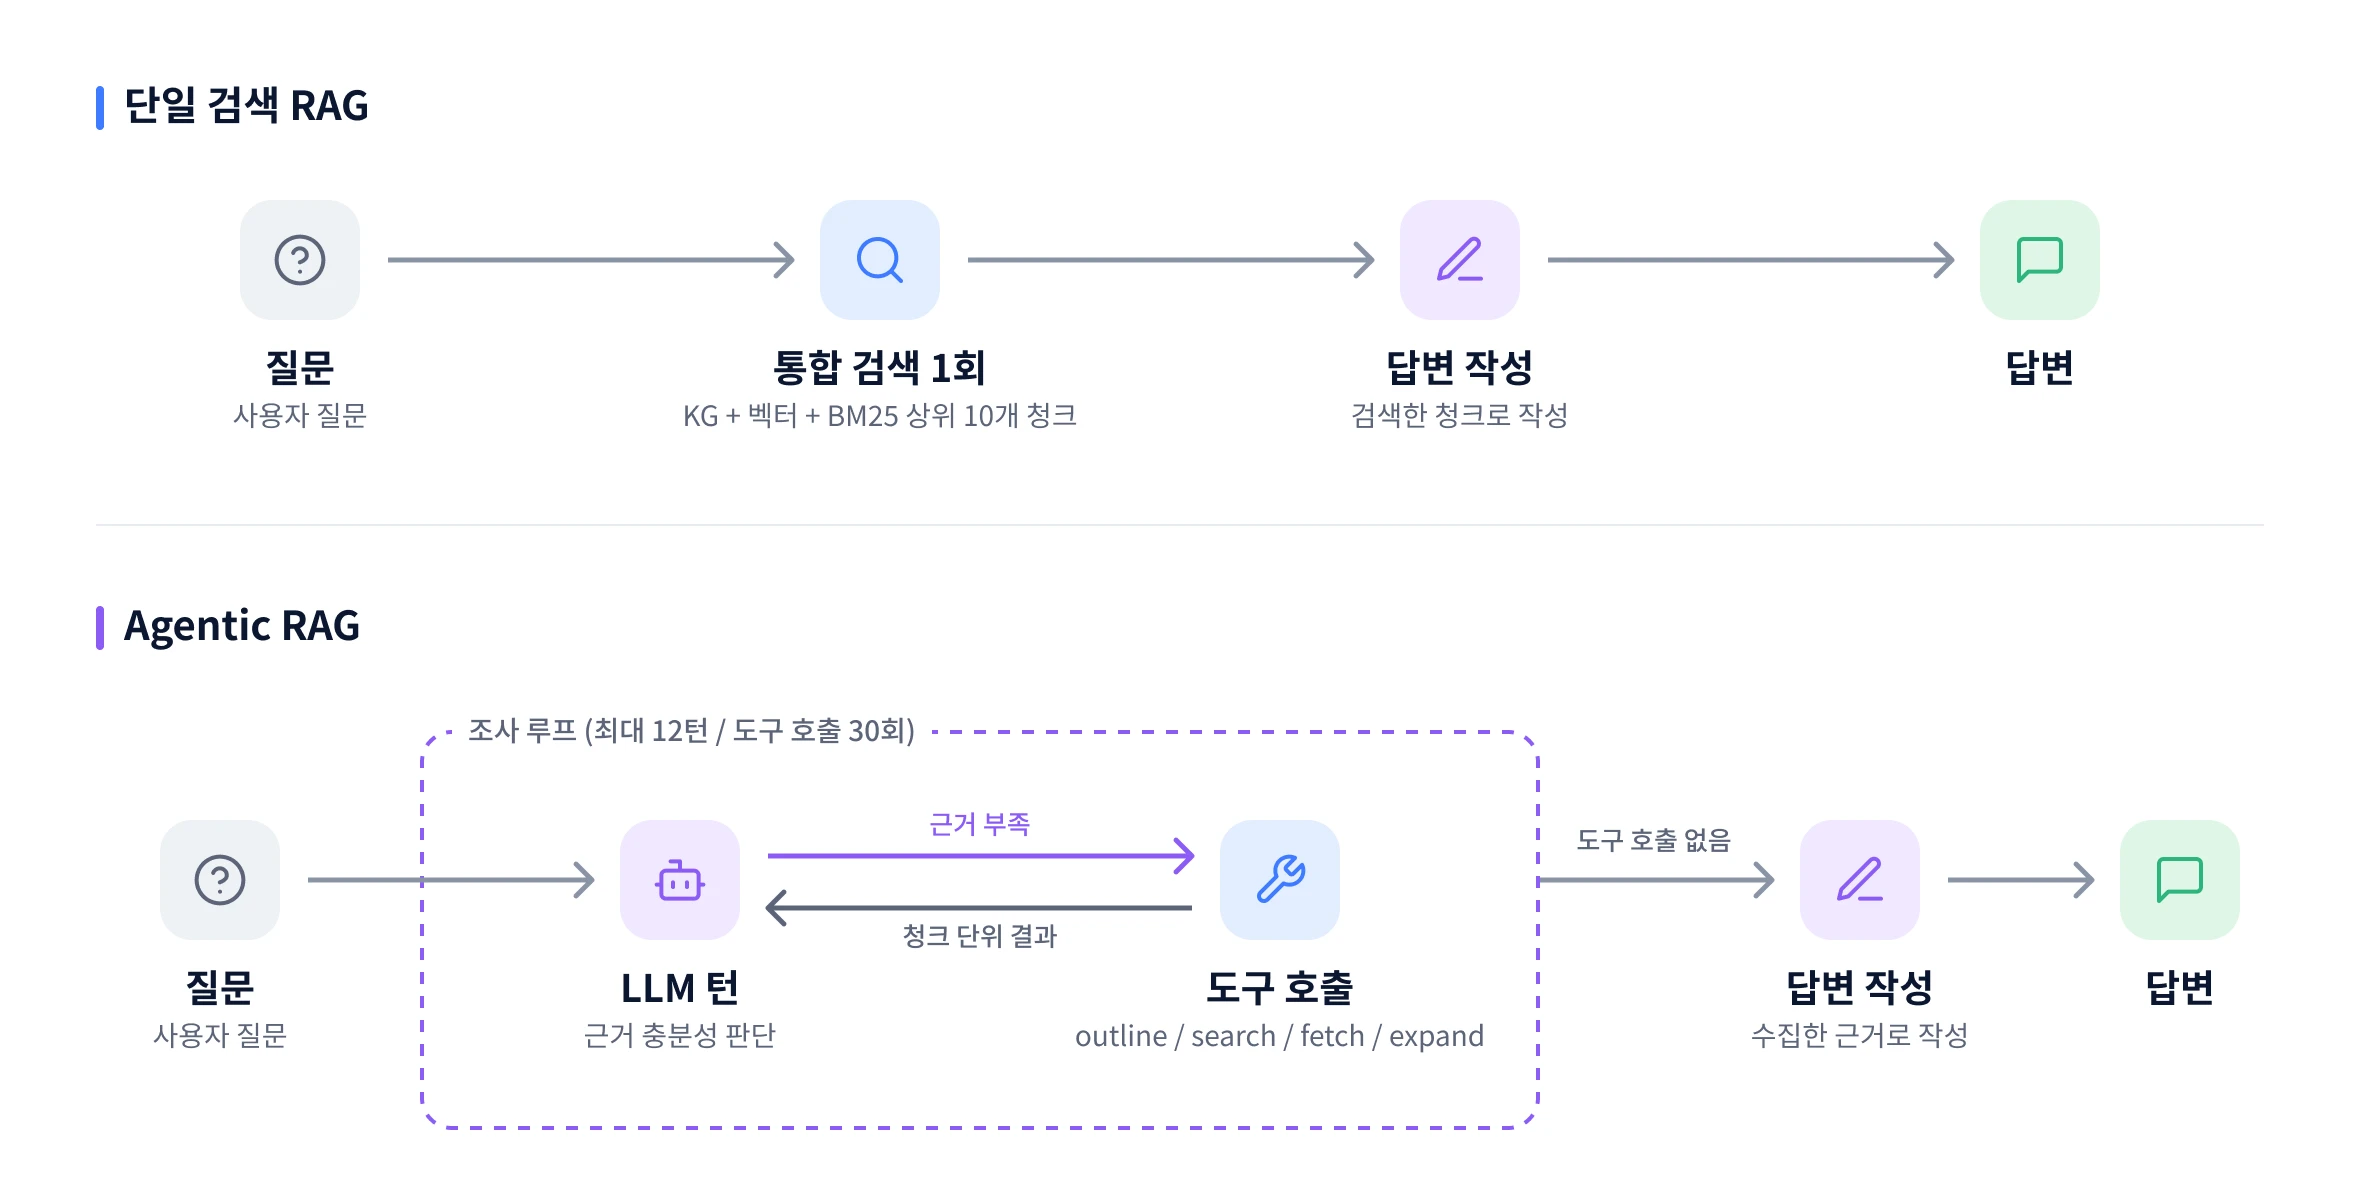
Agentic RAG는 LLM이 도구를 활용해 모은 근거들을 보고 스스로 충분성을 판단한 뒤, 필요하다면 후속 질의를 스스로 만들어 근거를 수집한 뒤 충분하다고 판단되면 질문에 대한 답변을 생성하는 방식입니다.
LLM에게 검색 도구와 각 도구의 사용 설명만 제공하고 어떤 도구를 언제 호출할지는 LLM이 결정합니다. 지정된 동작을 수행하는 코드는 아래 세 가지만 담당합니다.
- 상한: 턴 수와 도구 호출 수와 호출당 제한 시간
- 권한: 사용자가 볼 수 있는 문서만 검색되도록 모든 도구에 권한 조건을 적용
- 기록: 도구 호출과 토큰 사용량과 비용을 질의 로그에 기록
검색 도구
기존 검색 도구는 결과를 하나의 긴 텍스트로 반환했습니다. 이 형식에서는 이미 확인한 청크가 다시 검색되었는지 알 수 없고, 집중적으로 파고 들어야할 정보를 타겟팅하는 방식으로 검색 범위를 좁힐 방법도 없었습니다. 여러 번 검색하려면 확인한 청크를 식별할 수 있어야 하므로 검색 결과를 청크 단위로 반환하는 도구 네 개를 새로 만들었습니다.
| 계층 | 도구 | 역할 | LLM 호출 |
|---|---|---|---|
| 탐색 | outline |
어떤 문서가 있는지 확인 | 없음 |
| 탐색 | search |
질의와 유사한 청크 검색 | 키워드 추출 1회 (필터를 적용하면 없음) |
| 열람 | fetch |
검색한 청크의 본문 전체 조회 | 없음 |
| 열람 | expand |
같은 문서 안의 앞뒤 청크 조회 | 없음 |
탐색과 열람 도구는 답변을 생성하지 않으므로 여러 번 호출해도 비용이 많이 나오지 않습니다.
search만 Knowledge Graph(KG)를 함께 검색할 때 키워드 추출을 위해 LLM을 한 번 호출하고, 나머지 도구들은 임베딩 모델만 호출하여 매우 적은 비용으로 검색을 수행합니다.
LLM이 이 도구들을 여러 번 호출하면서 필요에 따라 검색 범위를 넓히고 좁히도록 설계했습니다.
네 도구에는 공통 규칙이 있습니다.
- 모든 결과는 청크 ID나 문서 ID를 포함한 JSON으로 반환합니다. LLM은 이 ID를 다음 도구 호출의 입력으로 활용할 수 있습니다.
- 모든 도구는 요청한 사용자의 권한 조건을 먼저 적용합니다. 질의를 보낸 사용자가 보면 안되는 문서는 검색 결과에 포함되지 않습니다.
- 지원하지 않는 값을 전달하면 무시하지 않고 사유와 함께 오류를 반환합니다. 서버가 잘못된 값을 기본값으로 바꿔 처리하면 LLM은 엉뚱한 범위를 검색하고도 요청한 범위를 검색했다고 판단하기 때문입니다.
- 결과의 각 문서에는 작성일과 최종 수정일을 함께 표시합니다. 이 날짜는 뒤의 작성 단계 개선에서 추가한 정보입니다.
도구들은 FastMCP로 묶어 배포했고, 각 도구의 사용법은 도구 설명(docstring)에 기재했습니다. LLM은 이 설명을 읽고 도구를 선택합니다. 도구 전체에 대한 안내문에는 아래와 같은 기본 흐름을 제시했습니다.
1
2
3
4
5
6
1. (선택) outline으로 어떤 문서가 있는지 확인한다. 질문으로 들어온 키워드를 잘 모를때만 사용한다.
2. search로 넓게 탐색한다. 유사도 최고값으로 결과의 신뢰도를 먼저 판단한다.
3. 필터로 범위를 좁히고 이미 확인한 청크는 제외 목록으로 중복해서 나오지 않게 한다.
   필요한 청크를 이미 찾았다면 재검색보다 expand가 정확하다.
4. 발췌로 판단할 수 없는 청크만 fetch로 조회하고 문맥이 끊기면 expand로 앞뒤 청크를 조회한다.
5. 대부분 여기서 끝난다. 확보한 원문으로 답변하고 인용한다.
search
질의와 유사한 청크를 찾아 청크 단위로 반환합니다.
검색 범위(scope)가 전체이면 KG, 벡터 검색, BM25를 결합한 통합 검색을 사용하고 특정 범위를 지정하면 해당 범위에서 벡터 검색을 수행합니다.
통합 검색은 KG에서 엔티티와 관계를 찾기 위해 LLM으로 질의의 키워드를 먼저 추출합니다.
즉 필터 없이 전체 범위를 검색하면 호출마다 키워드 추출 LLM이 한 번 실행됩니다.
반면 필터나 제외 목록을 적용하면 벡터 검색만 사용하므로 LLM을 호출하지 않습니다.
1
2
3
4
5
6
7
8
9
10
11
@mcp.tool()
async def search(query, scope="all", top_k=10, format="compact",
                 filters=None, exclude_chunk_ids=None) -> str:
    if scope not in VALID_SCOPES:    # 잘못된 범위는 기본값으로 바꾸지 않고 거부
        return error(f"지원하지 않는 scope: {scope}", valid_scopes=VALID_SCOPES)

    # 필터나 제외 목록이 있으면 KG를 거치지 않고 벡터 검색만 사용
    mode = "naive" if (filters or exclude_chunk_ids) else "mix"
    ...
    # compact는 문서 경로와 본문 앞 1000자만 반환
    body = excerpt(c["content"]) if format == "compact" else c["content"]
주요 파라미터의 의도는 다음과 같습니다.
format: 기본값인compact는 문서 경로와 본문 앞 1,000자만 반환합니다. 청크 본문 길이의 중앙값이 721자이므로 절반 이상의 청크는 발췌만으로 본문 전체가 전달됩니다. 정찰 단계에서full로 전문을 받으면 검색 한 번에 수만 자가 입력되므로 발췌로 후보를 좁힌 뒤 잘린 청크만fetch로 전문을 조회하게 했습니다.filters: 첨부파일, 특정 페이지의 첨부파일, 특정 문서, 특정 문서 제외, 특정 대화 채널로 한정하는 조건을 지원합니다. 필터를 적용하면 KG 확장을 끄고 벡터 검색만 사용합니다.exclude_chunk_ids: 앞선 호출에서 받은 청크 ID를 전달하면 그 청크를 제외하고 다음 순위의 청크가 반환됩니다.
검색 결과는 다음과 같습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
{
  "status": "success",
  "chunks": [
    {
      "chunk_id": "chunk-3f2a91",
      "file_path": "이미지 서비스/API/이미지 목록 API.md",
      "source": "docs",
      "rank": 1,
      "cosine": 0.4712,
      "excerpt": "이미지 서비스 > API > 이미지 목록 API\n\n응답 필드: image_id / file_name / status ...",
      "doc_created": "2026-03-24",
      "doc_updated": "2026-07-08"
    }
  ],
  "truncated": true,
  "scope_coverage": {"docs": "ok", "chat": "acl_denied"}
}
LLM이 결과를 읽을 때 기준으로 삼도록 안내문에 기재한 내용은 다음과 같습니다.
rank: 기존 검색의 RRF 순위를 그대로 사용합니다.cosine: 융합 전 질의와 청크의 cosine 연관도입니다. RRF는 순위만 사용하므로 결과가 질의와 관련 있는지는 이 값으로 판단합니다.scope_coverage: 범위별로 결과를 검색했는지 표시합니다.acl_denied는 정보가 없는 것이 아니라 권한이 없는 것이므로 “자료에 없다”가 아니라 “권한이 없어 확인할 수 없다”고 답변하게 했습니다.
fetch
검색 결과의 발췌만으로 판단할 수 없는 청크의 본문 전체를 조회합니다. 검색을 다시 실행하지 않고 저장소에서 청크 ID로 바로 조회하므로 임베딩과 LLM 비용이 모두 발생하지 않습니다.
1
2
3
4
5
6
7
8
9
10
11
with user_acl(user_id):
    found = {r["id"]: r for r in await text_chunks.get_by_ids(chunk_ids) if r}
    allowed = await chunks_vdb.filter_allowed_ids(list(found))   # 권한 조건 적용

for cid in chunk_ids:
    if cid not in found:
        missing.append({"chunk_id": cid, "reason": "not_found"})
    elif cid not in allowed:
        missing.append({"chunk_id": cid, "reason": "forbidden"})  # 내용은 반환하지 않음
    else:
        chunks.append({**found[cid], "source": ws})
조회하지 못한 청크는 사유와 함께 missing으로 반환합니다.
not_found는 그런 청크가 없다는 뜻이고 forbidden은 청크는 있지만 권한이 없다는 뜻입니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
{
  "status": "success",
  "chunks": [
    {
      "chunk_id": "chunk-3f2a91",
      "source": "docs",
      "file_path": "이미지 서비스/API/이미지 목록 API.md",
      "full_doc_id": "doc-B",
      "chunk_order_index": 2,
      "content": "(청크 본문 전체)"
    }
  ],
  "missing": [{"chunk_id": "chunk-77c0e4", "reason": "forbidden"}],
  "scope": "docs"
}
응답 형식은 search 도구와 거의 차이가 없지만, 청크 전체가 항상 잘리지 않고 제공된다는 차이가 있습니다.
expand
기준 청크의 앞뒤 청크를 같은 문서 안에서 가져옵니다.
이 도구는 여러 청크에 걸쳐있는 긴 표나 글이 제대로 검색되지 않는 문제를 해결하기 위해 도입되었습니다.
실제로 초기 테스트 과정에서 필드 표의 앞부분이 들어 있는 청크를 찾은 뒤 이미 확인한 청크를 제외하고 다시 검색했지만 표의 나머지 부분은 검색되지 않는 문제가 있었습니다.
따라서 여러 청크에 걸친 내용은 재검색이 아니라 찾은 청크를 기준으로 이어서 조회하는 도구가 필요하다고 판단해 expand를 추가했습니다.
1
2
3
4
5
6
idx = anchor["chunk_order_index"]
# 같은 문서 안의 순서 범위만 조회하므로 문서 경계를 넘지 않는다
rows = await text_chunks.get_doc_chunk_range(anchor["full_doc_id"], max(0, idx - before), idx + after)

# 같은 문서라도 권한이 같다고 보장할 수 없으므로 이웃 청크도 권한 조건을 다시 적용한다
chunks, missing, _ = await resolve_chunks([r["id"] for r in rows], scope, user_id)
before와 after는 각각 0~20이고 기본값은 1입니다.
결과는 문서 안의 순서대로 정렬되고 기준 청크가 문서의 첫 청크이면 앞쪽은 빈 결과가 됩니다.
1
2
3
4
5
6
7
8
9
10
11
12
{
  "status": "success",
  "chunks": [
    {"chunk_id": "chunk-1b8d20", "chunk_order_index": 1, "content": "| 필드 | 타입 | 설명 |\n|---|---|---|"},
    {"chunk_id": "chunk-3f2a91", "chunk_order_index": 2, "content": "| image_id | string | 이미지 식별자 | ..."},
    {"chunk_id": "chunk-c4e7a5", "chunk_order_index": 3, "content": "응답 예시 ..."}
  ],
  "missing": [],
  "full_doc_id": "doc-B",
  "anchor_index": 2,
  "scope": "docs"
}
outline
사용자가 볼 수 있는 문서의 목록을 반환합니다.
질의로 들어온 키워드를 LLM이 잘 모른다고 판단하면 Outline 도구를 활용해 먼저 관련 문서 목록을 훑고, 검색어와 필터를 정확하게 정하게 됩니다.
질문에 문서 이름이 드러나지 않을 때 주제어로 문서 제목을 검색하는 용도로도 사용합니다.
1
2
3
4
5
6
7
8
9
with query_filters(filters), user_acl(user_id):
    agg = await chunks_vdb.aggregate_doc_ids()   # 권한과 필터를 통과한 청크를 문서별로 집계

if q:   # 제목 / 트리 경로 / 파일 경로의 부분 문자열로 필터
    entries = [e for e in entries if q.lower() in (e["title"] + e["breadcrumb"] + e["file_path"]).lower()]

# q가 없으면 반환한 목록이 아니라 전체 문서 수를 기준으로 잘림 여부를 계산
matched = len(entries) if q else len(agg)
truncated = matched > limit
문서에는 별도의 제목 필드가 없으므로 본문 맨 앞에 있는 breadcrumb 제목과 문서 경로를 추출해 제구성했습니다.
위키 문서는 본문 첫 줄에 상위 페이지 링크가 이어진 경로가 있으므로 이 줄에서 링크 주소를 제거해 상위 페이지 > 하위 페이지 형태의 경로를 만듭니다.
첨부파일에는 이 경로가 없는 대신 첨부파일이 속한 페이지의 ID(parent_page_id)가 있으므로 이 값을 검색 필터에 전달하면 같은 페이지의 첨부파일을 모을 수 있습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
{
  "documents": [
    {
      "full_doc_id": "doc-B",
      "title": "이미지 목록 API",
      "breadcrumb": "이미지 서비스 > API",
      "file_path": "이미지 서비스/API/이미지 목록 API.md",
      "chunk_count": 4,
      "doc_kind": "page",
      "parent_page_id": null,
      "doc_created": "2026-03-24",
      "doc_updated": "2026-07-08"
    }
  ],
  "matched_documents": 12,
  "total_documents": 977,
  "truncated": false,
  "scope": "docs"
}
기본 정렬은 청크 수가 많은 순서입니다.
상한과 실패 처리
| 항목 | 값 | 설명 |
|---|---|---|
| 최대 턴 | 12 | 마지막 턴은 답변 작성용으로 예약 |
| 최대 도구 호출 | 30 | 사실상 비용 상한 |
| 호출당 제한 시간 | 240초 | LLM 호출 한 번의 제한 시간 |
Agentic RAG는 LLM이 직접 충분하다고 판단하기 전까지는 계속해서 루프를 돌며 자료를 찾게됩니다. 이때 별도의 상한 조건이 없으면, 이론상 무한하게 검색을 수행할 수도 있습니다.
이런 문제를 방지하기 위해, 상한을 미리 정해두고 상한은 LLM이 아닌 코드가 제어하게 구현했습니다. 상한에 도달하면 이후 턴에서는 도구를 호출할 수 없도록 API 옵션으로 막고 답변을 작성하게 합니다.
조사 모델과 작성 모델 분리
Agentic RAG는 근거를 찾는 조사 단계와 답변을 작성하는 작성 단계로 구분됩니다.
처음에는 gpt-5.6-luna 하나가 두 단계를 모두 처리했습니다.
이후 단가가 절반이면서 밴치마크 성능이 더 좋은 gpt-6-luna로 교체하자 답변에 담긴 정보가 지나치게 생략되고 짧아지는 문제가 생겼습니다.
원인을 확인하기 위해 gpt-6-luna의 조사 결과를 고정하고 답변만 다시 작성하는 실험을 36회 진행했습니다.
답변 작성도 gpt-6-luna로 하면서 아래 조건을 하나씩 바꾸었고 마지막 조건에서만 작성 모델을 gpt-5.6-luna로 바꾸었습니다.
| 변경한 조건 | 답변 본문 길이 |
|---|---|
| 답변 지시문 5종 (현행 / 조사 원칙 제거 / 형식 규칙 제거 등) | 모두 약 1,500토큰 |
| 근거 전달 형식 3종 (이전 대화에 이어서 / 새 요청 원문 / 새 요청 중복 제거) | 모두 약 1,500토큰 |
| 추론 강도 high ↔ medium | 추론 토큰만 4,600 → 900으로 감소하고 본문은 동일 |
| 대상마다 소제목을 만들도록 구조 강제 | 소제목은 1개 → 4개로 늘었지만 본문은 10~25% 증가 |
같은 근거를 gpt-5.6-luna에게 전달 |
약 3,250토큰 (2.9배) |
지시문 변경, 근거 형식 변경, 추론 강도 변경 모두 지나치게 요약하는 답변 생성 기조는 거의 변하지 않았고, gpt-5.6-luna으로 모델을 변경했을 때만 크게 달라졌습니다.
반면 조사 단계에서는 gpt-6-luna가 더 넓고 깊게 탐색하는 경향이 있었습니다.
같은 질문에서 gpt-6-luna는 고유 청크를 105~125개 확인했고 gpt-5.6-luna는 54개를 확인했습니다.
즉 짧아진 원인은 조사가 아니라 작성 모델의 성향이었습니다.
이에 따라 조사는 검색을 넓게 수행하는 gpt-6-luna(추론 강도 high)가 담당하고 답변은 자세하게 작성하는 gpt-5.6-luna(추론 강도 medium)가 담당하도록 분리했습니다.
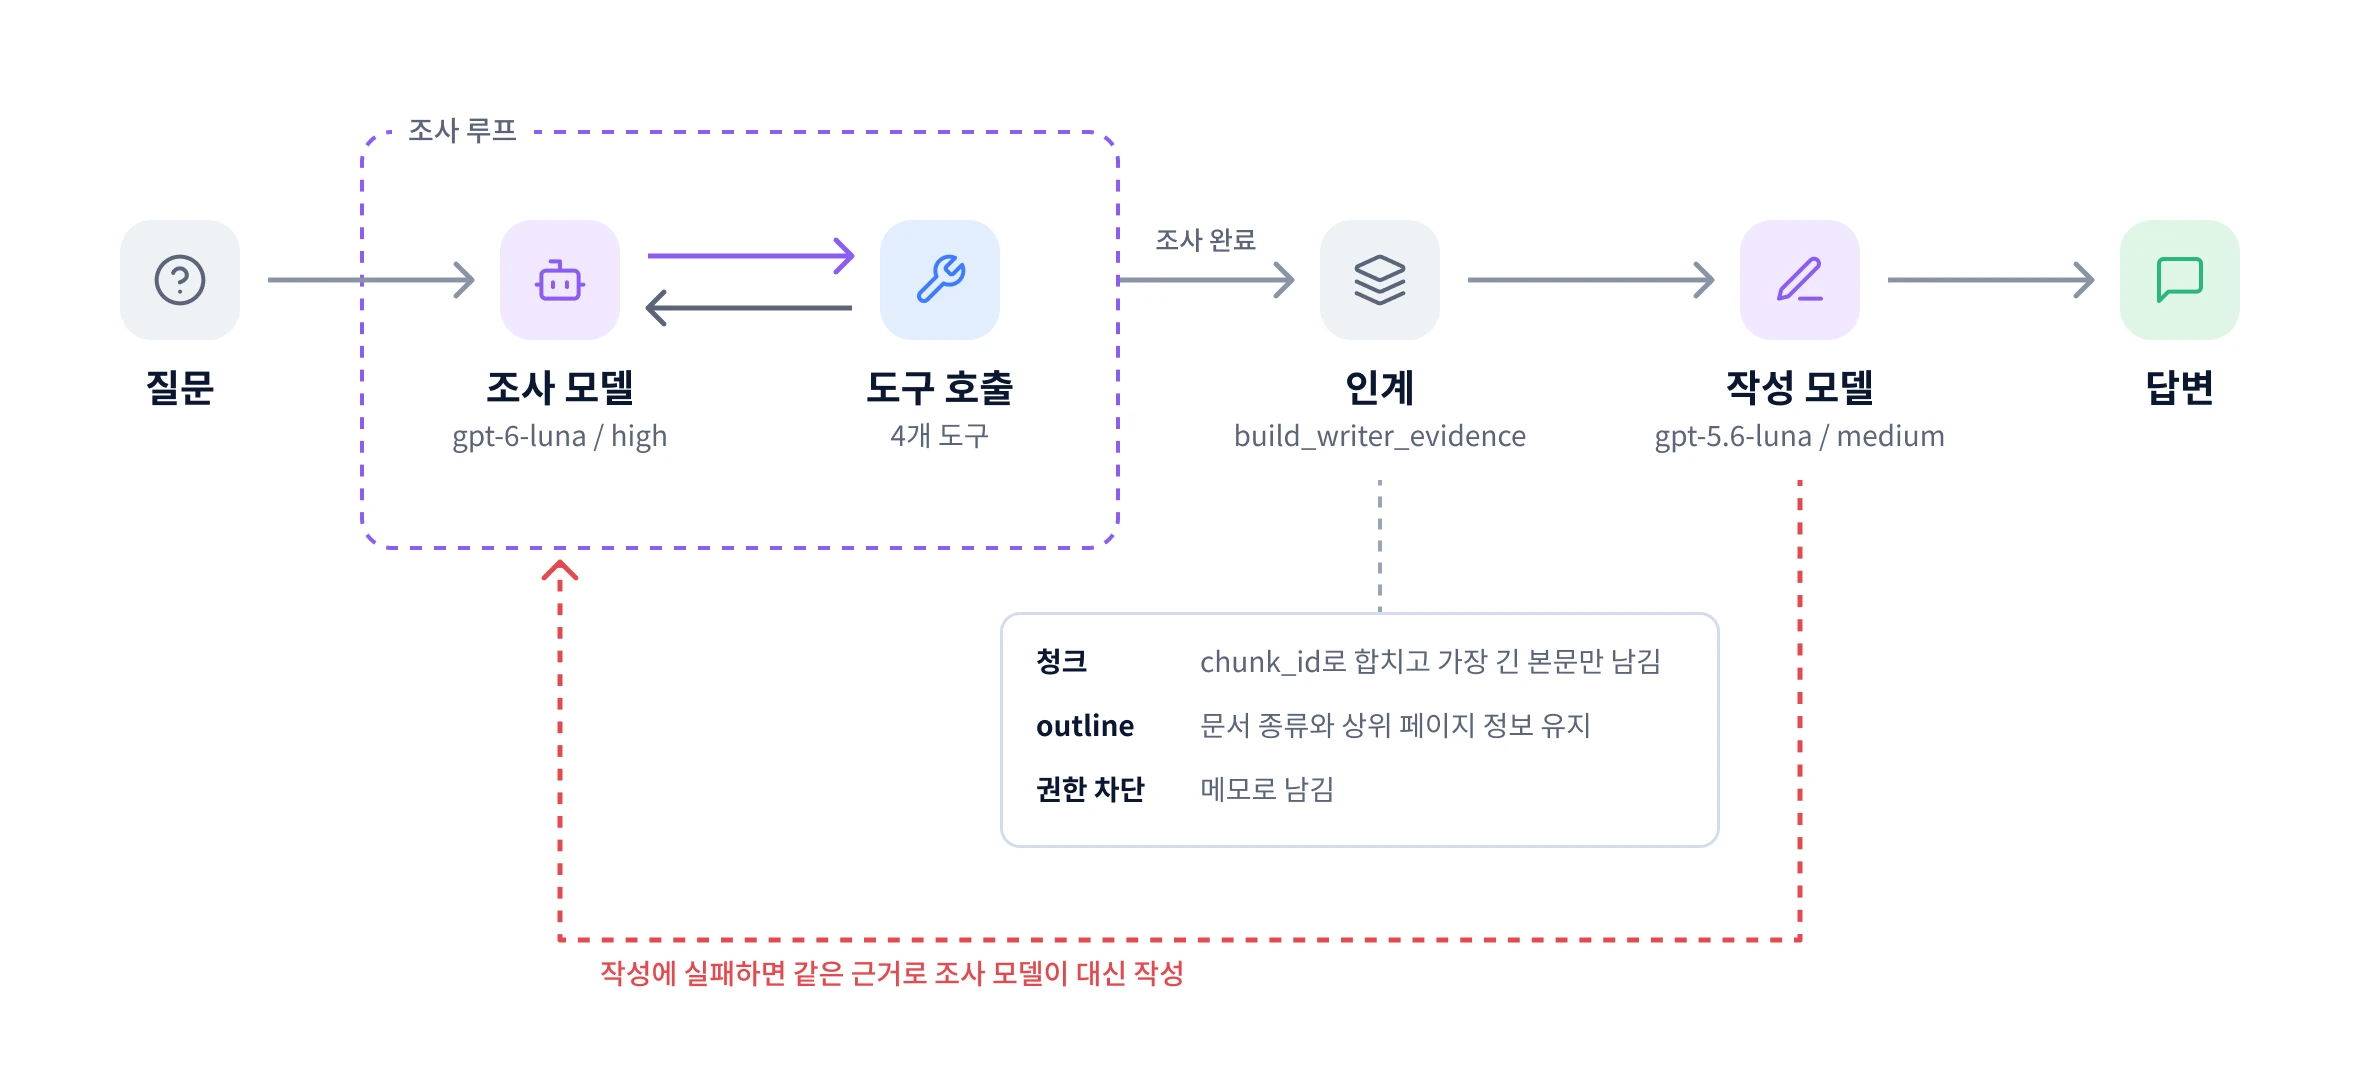
하지만 조사/답변 모델을 분리하니 답변 모델의 입력 컨텍스트 비용이 지나치게 커지는 문제가 발생했습니다. 그래서 인계 단계에서는 여러 검색에서 반복되는 중복 청크를 ID로 판별해서 제거하게 했고, 작성 모델에게 전달하는 도구 결과가 18.6만 자에서 8.9만 자로 평균 52% 감소했습니다.
직전 구조와 비교
이 시점에는 새 평가셋이 없었으므로 성능 점수 대신 비용과 응답 시간과 답변 길이를 비교했습니다. 아래는 복합 질문 10개를 실행한 결과입니다.
| 항목 | Agentic RAG (단일 모델) | 조사와 작성 분리 |
|---|---|---|
| 평균 응답 시간 | 48.0초 | 104.7초 |
| 비용 (10문항 합계) | 0.167달러 | 0.341달러 |
| 평균 도구 호출 | 8.4회 | 16.6회 |
| 평균 답변 길이 | 5,925자 | 8,252자 |
답변은 39% 길어졌고 경로와 필드명 같은 구체적인 정보가 늘었습니다. 대신 응답 시간과 비용이 약 두 배가 되었습니다. 늘어난 비용은 작성 모델과 도구 호출 증가가 원인입니다. 작성 모델은 입력과 출력 단가가 조사 모델의 2~2.4배이고 인계 입력은 매번 새 요청이므로 프롬프트 캐시가 거의 적용되지 않았습니다(5%).
조사가 끝난 뒤 작성 모델이 답변을 작성하는 단계가 추가되면서 응답 시간도 늘었습니다. 작성 호출에는 15~30초가 걸렸고 이 시간은 전체 응답 시간의 25~30%였습니다.
비용 절감
작성자 분리로 비용이 두 배가 되었으므로 다음으로 비용을 줄였습니다. 먼저 질문당 비용이 어디에서 발생하는지 나누어 확인했습니다.
| 비용 구성 | 설계 질문 | 실사용 질문 | 복합 질문 |
|---|---|---|---|
| 조사 입력: 새 도구 결과 (캐시 미적용) | 36% | 31% | 35% |
| 조사 입력: 이전 턴 재전송 (캐시 적용) | 12% | 11% | 15% |
| 조사 출력 | 4% | 4% | 4% |
| 작성 입력 | 37% | 36% | 31% |
| 작성 출력 (답변) | 11% | 19% | 15% |
비용의 약 80%가 입력이었습니다. 조사 루프에서는 한 번 받은 도구 결과가 이후의 모든 턴에 다시 전달됩니다. 게다가 같은 청크가 여러 검색에서 반복되므로 같은 청크가 여러 번 입력됩니다. 실제로 작성 모델에게 인계할 때 중복을 제거하면 전체의 41 ~ 56%가 사라졌습니다.
이미 확인한 청크 생략
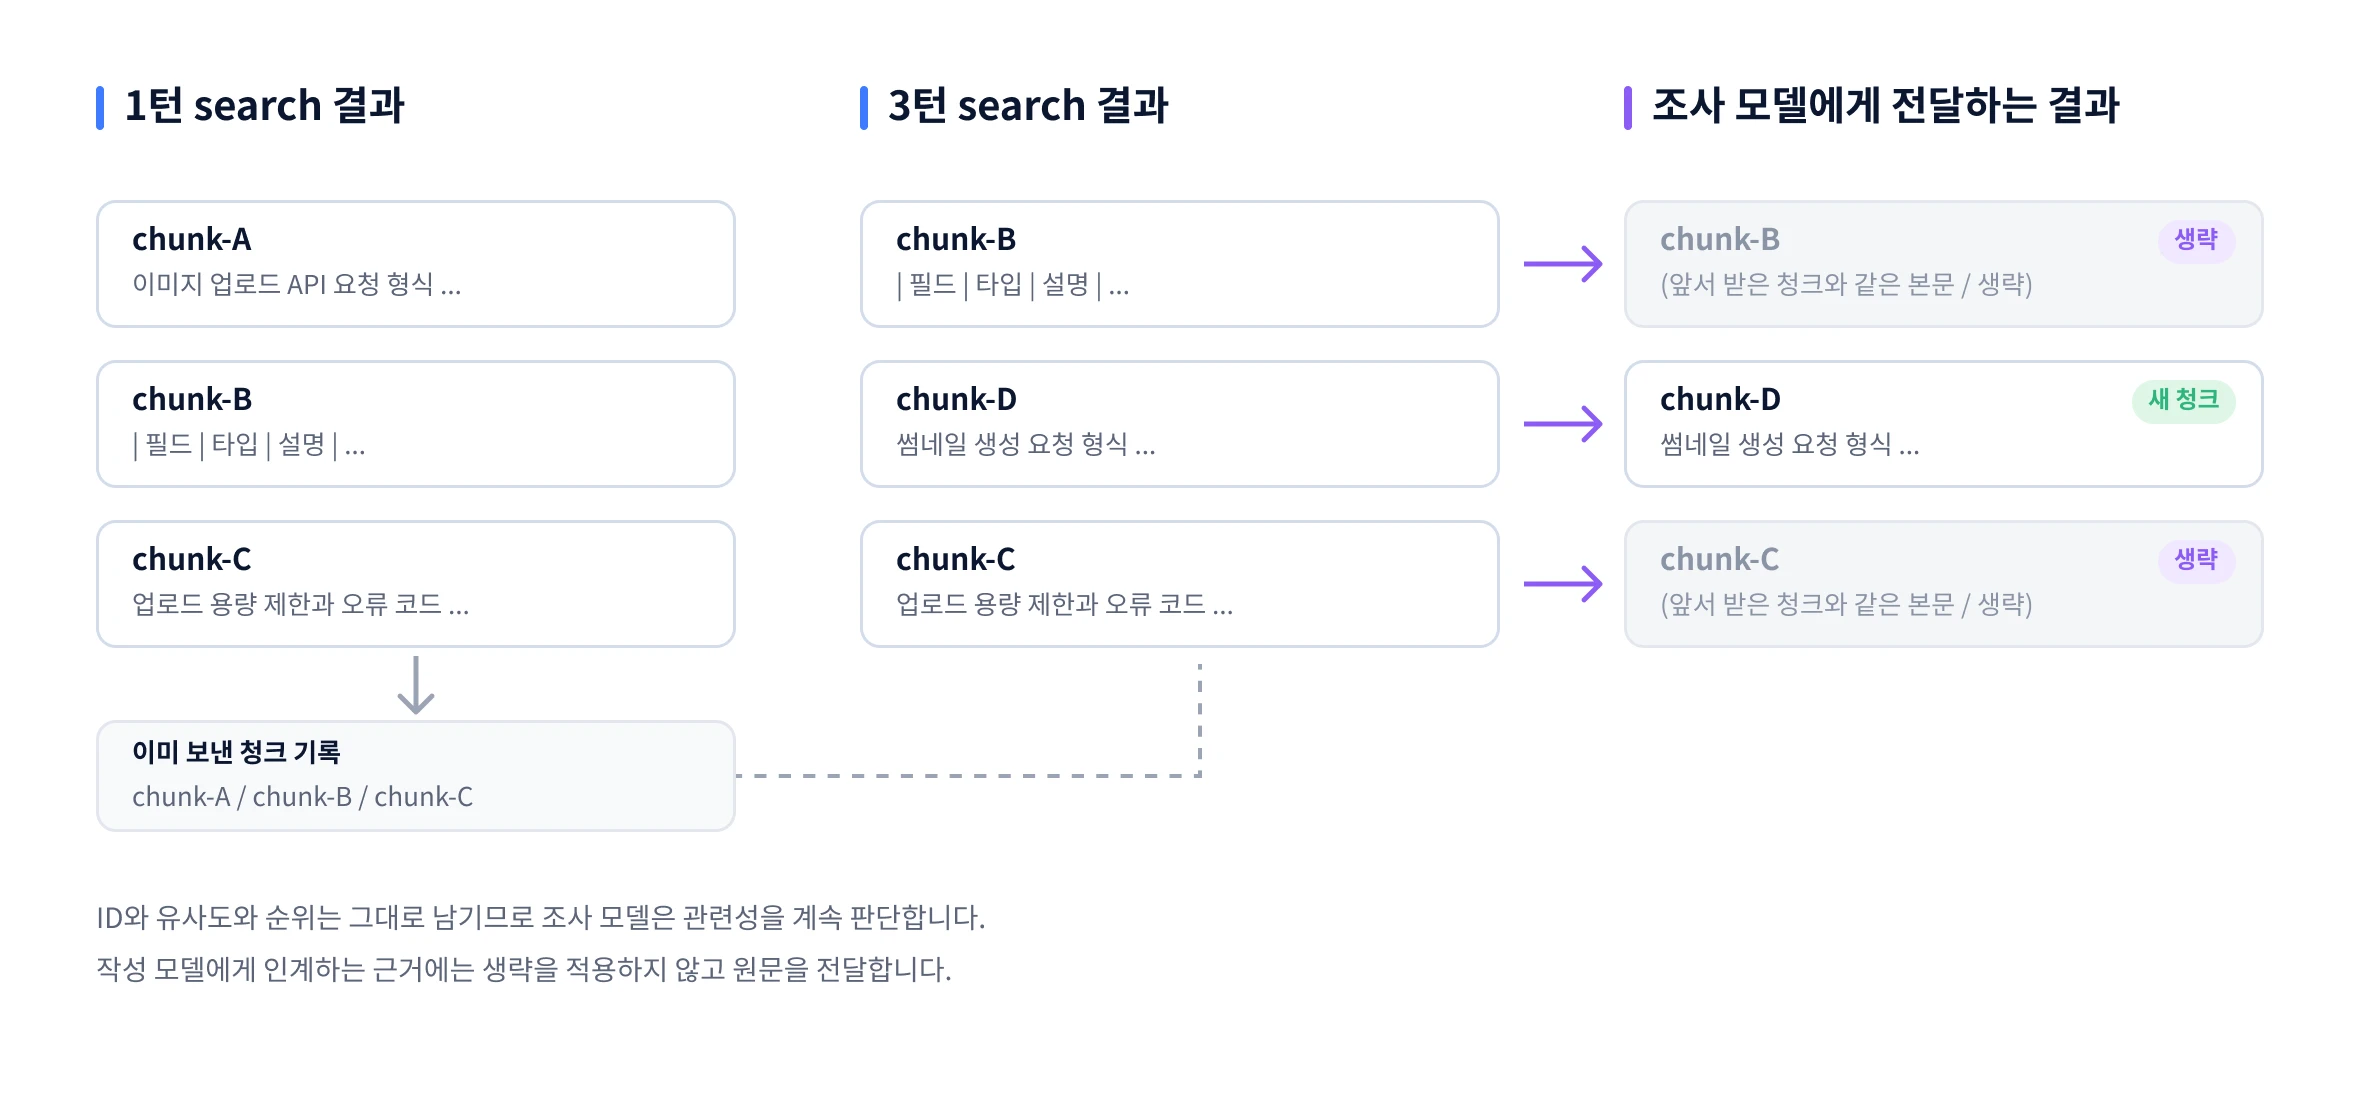
조사 모델에게 이미 전달한 청크가 다시 검색되면 본문만 생략 표시로 바꿉니다.
1
2
3
4
5
6
for c in data["chunks"]:
    body = c.get("content") or c.get("excerpt") or ""
    if sent.get(c["chunk_id"], -1) >= len(body):
        c["excerpt"] = "(앞서 받은 청크와 같은 본문 / 생략)"   # ID / 유사도 / 순위는 유지
    else:
        sent[c["chunk_id"]] = len(body)   # 발췌 뒤에 받은 전문처럼 더 긴 본문은 그대로 전달
청크 ID와 유사도와 순위와 파일 경로는 그대로 남기므로 조사 모델은 관련성을 계속 판단할 수 있습니다. 이 처리는 조사 모델에게 보내는 도구 결과에만 적용하고 작성 모델에게 인계하는 근거는 원문을 유지했습니다. 새로 들어오는 결과에만 적용하므로 이전 턴의 입력은 변하지 않고 프롬프트 캐시도 그대로 적용됩니다. 조사 원칙에는 생략 표시는 앞선 결과에 본문이 있다는 뜻이므로 다시 조회하지 말라는 문장을 추가했습니다.
작성자 분리 직후와 같은 25문항으로 비교한 결과는 다음과 같습니다.
| 항목 | 작성자 분리 직후 | 이미 확인한 청크 생략 |
|---|---|---|
| 25문항 비용 합계 | 0.612달러 | 0.496달러 (−19%) |
| 복합 질문당 비용 | 0.0341달러 | 0.0265달러 (−22%) |
| 복합 질문당 조사 입력 | 636,907토큰 | 445,722토큰 (−30%) |
| 복합 질문 평균 도구 호출 | 16.6회 | 18.9회 |
| 복합 질문 캐시 적중률 | 81% | 84% |
복합 질문에서는 도구를 더 많이 호출했는데도 조사 입력이 30% 감소했습니다. 도구 호출이 1~4회뿐인 질문은 중복이 발생하지 않으므로 변화가 없었습니다.
조사 모델의 추론 강도 낮추기
작성자를 분리한 뒤에는 조사 모델의 추론 강도가 얼마나 넓고 깊게 검색하는지에만 영향을 줍니다. 그래서 추론 강도를 high에서 medium으로 낮춰도 작성 품질이 유지되는지 확인했습니다. 두 설정 모두 이미 확인한 청크의 생략을 적용한 상태에서 비교했습니다.
| 항목 | high | medium |
|---|---|---|
| 25문항 비용 합계 | 0.496달러 | 0.377달러 (−24%) |
| 복합 질문 평균 도구 호출 | 18.9회 | 12.4회 |
| 복합 질문당 작성 모델에게 전달한 청크 | 103개 | 89개 |
| 설계 질문 응답 시간 | 56.0초 | 37.9초 (−32%) |
| 실사용 질문 응답 시간 | 71.1초 | 41.2초 (−42%) |
medium에서는 복합 질문의 도구 호출이 18.9회에서 12.4회로 약 3분의 1 줄었고 이 조사량의 감소가 비용 절감의 원인이었습니다. 다만 복합 질문에서는 조사가 줄어 세부 사항이 빠진 답변이 있었습니다. 그래도 조사와 작성을 한 모델이 처리하던 구조보다 비용이 6% 낮았으므로 비용을 우선해 medium을 선택했습니다.
여기까지 적용된 Agentic RAG가 초기의 Agentic RAG로, 아래에서 초기 Agentic RAG로 측정했습니다. 초기 Agentic RAG는 이후 Agentic RAG와 비교하는 기준이 됩니다.
베이스라인과 초기 Agentic RAG 측정
베이스라인: 단일 검색 RAG
베이스라인은 Agentic RAG를 도입하기 전의 단일 검색 RAG입니다. 단일 검색은 질문으로 통합 검색(KG + 벡터 검색 + BM25)을 한 번 실행하고 반환된 청크로 답변을 작성합니다. 검색 지표는 반환된 상위 10개 청크로 계산했습니다. 실행할 때마다 결과가 달라지므로 운영 데이터를 로컬로 복사한 스냅샷에서 5회 측정했습니다. 측정 기록을 만드는 방식은 지난 글의 측정 방법과 같습니다.
| 지표 | 베이스라인 (5회 평균 / 범위) |
|---|---|
| Doc Hit@10 | 0.978 (0.963~0.988) |
| All Docs@10 | 0.595 (0.588~0.613) |
| Evidence Recall@10 | 0.604 (0.582~0.615) |
| All Evidence@10 | 0.273 (0.250~0.287) |
| MRR | 0.873 (0.866~0.884) |
| 응답 시간 (중앙값) | 5.7초 (검색만) |
정답 문서를 하나라도 찾는 Doc Hit는 0.978이지만 필요한 근거를 모두 찾은 문항의 비율인 All Evidence는 0.273입니다. 이 결과에서 단일 검색은 첫 번째 문서는 찾지만 여러 문서에 걸친 근거를 모두 찾지 못한다는 사실을 알 수 있습니다. 베이스라인은 검색 지표만 측정했고 답변은 생성하지 않았으므로 Correctness 같은 답변 지표는 없습니다.
초기 Agentic RAG
초기 Agentic RAG는 앞에서 설명한 구조를 모두 적용해 운영에 배포한 상태입니다.
- 검색 도구:
outline/search/fetch/expand(search결과는 본문 앞 1000자 발췌) - 루프 상한: 최대 12턴 / 도구 호출 최대 30회
- 모델 구성: 조사 모델(추론 강도 medium)과 작성 모델 분리
- 비용 절감: 이미 확인한 청크의 본문 생략
- 인덱스: 베이스라인과 같은 운영 인덱스 (다음 글에서 다룰 인덱싱 개선 전)
베이스라인과 같은 데이터에서 3회 측정했습니다. 답변 생성자에게 최종 전달되는 데이터에는 순위가 없으므로 상위 k개로 제한하지 않고 작성 단계로 전달된 근거 전체로 계산했습니다.
| 지표 | 베이스라인 (5회) | 초기 Agentic RAG (3회) |
|---|---|---|
| Doc Hit | 0.978 | 1.000 |
| All Docs | 0.595 | 0.925 (0.900~0.950) |
| Evidence Recall | 0.604 | 0.885 (0.876~0.891) |
| All Evidence | 0.273 | 0.683 (0.650~0.713) |
| 문항당 확인한 청크 | 10개 | 평균 약 40개 |
| 응답 시간 (중앙값) | 5.7초 (검색만) | 약 33초 (답변 작성 포함) |
All Evidence는 베이스라인의 0.273에서 0.683으로 약 2.5배가 되었습니다. 검색을 반복하면서 단일 검색이 놓치던 두 번째와 세 번째 근거를 상당 부분 수집했기 때문입니다. 두 방식이 확인하는 청크 수가 다르다는 점을 고려해도, Agentic RAG가 여러 문서 수집이 필요한 질의에서 상당한 개선을 보인다는것을 알 수 있습니다.
초기 Agentic RAG의 답변 지표는 다음과 같습니다.
| 지표 | 초기 Agentic RAG (3회 평균 / 범위) |
|---|---|
| Correctness | 0.881 (0.869~0.894) |
| Must-have Recall | 0.950 (0.941~0.957) |
| Must-have All | 0.796 |
| Faithfulness | 0.860 (0.838~0.906) |
| 실행 비용 (80문항) | 0.71~0.73달러 |
Must-have All은 핵심 사실(must_have)을 모두 포함한 답변의 비율입니다.
이후의 개선은 모두 이 초기 Agentic RAG에서 출발합니다. 각 개선 절에는 그 시점에 측정한 결과를 기재하고 바로 직전 단계와 비교했습니다.
오답의 원인 분석
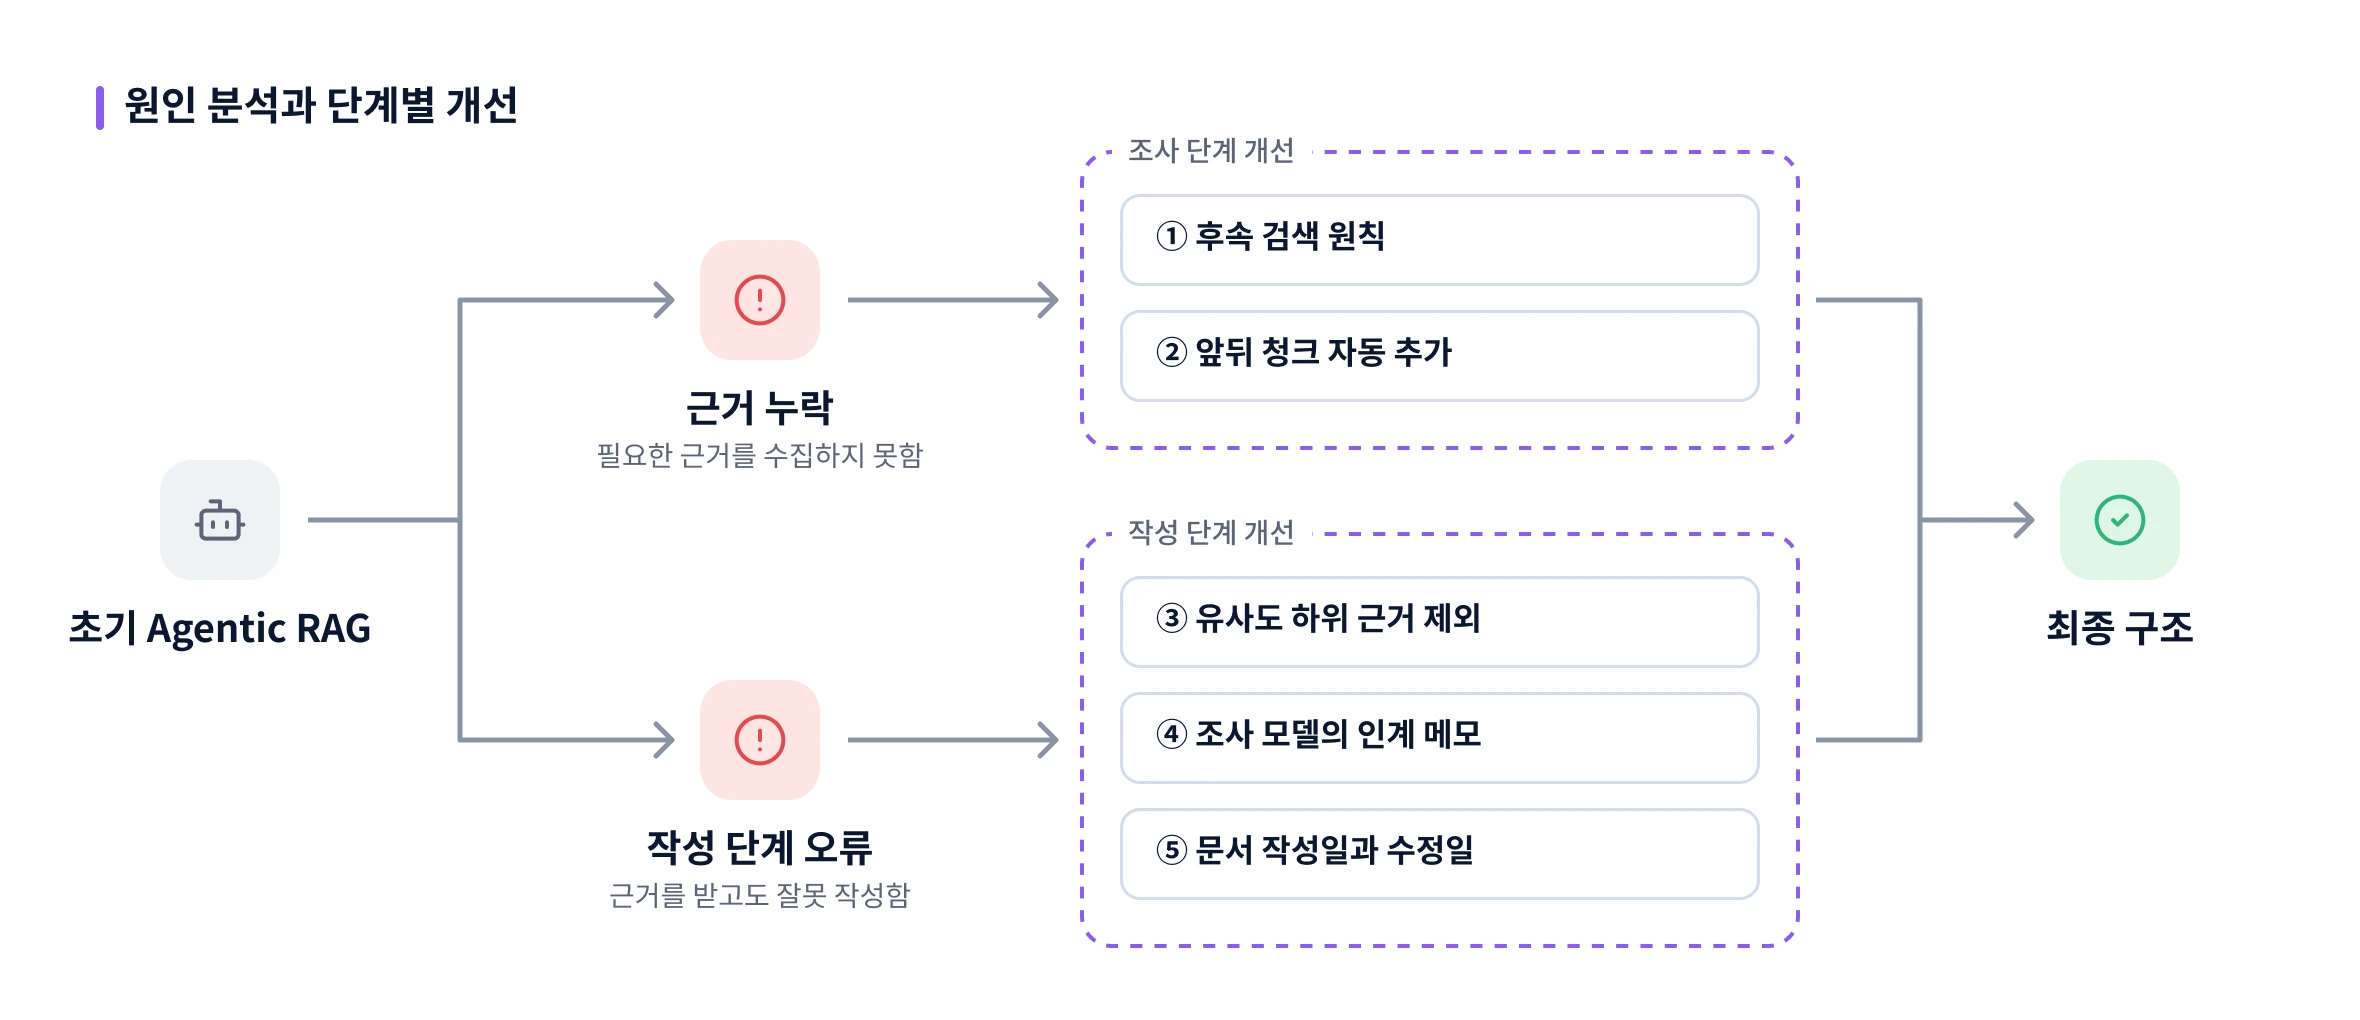
초기 Agentic RAG에서 한 번이라도 부분 정답이나 오답으로 판정된 문항은 28개였습니다. 문항별로 작성 단계에 전달된 근거를 확인한 결과 원인은 두 가지로 나뉘었습니다.
| 구분 | 문항 |
|---|---|
| 근거가 누락된 상태로 답변 | 21 |
| 근거를 모두 받고도 답변에서 누락하거나 오류 발생 | 7 |
근거가 모두 전달된 실행의 Correctness는 0.942였지만 근거가 누락된 실행은 0.750이었습니다. 따라서 오답의 대부분은 근거 수집 단계에서 발생하고 일부는 작성 단계에서 발생합니다.
근거 누락
근거가 누락된 원인을 확인하기 위해 측정 과정에서 발생한 3회 실행에서, 평가셋의 근거 인용 1,044개 중 작성 단계로 전달되지 않은 129개를 분류했습니다. 이 분류는 다음 글에서 다룰 인덱싱 개선을 적용한 데이터로 측정한 기록입니다.
| 원인 | 건수 | 설명 |
|---|---|---|
| 문서 자체를 검색하지 못함 | 46 | 정답 문서가 한 번도 검색되지 않음 |
| 문서는 찾았지만 필요한 청크가 없음 | 47 | 47건 중 30건은 이미 받은 청크에서 2칸 이내에 위치 |
| 청크는 받았지만 본문이 잘림 | 15 | 검색 결과는 본문 앞 1,000자만 반환하는데 fetch로 전문을 조회하지 않음 |
| 인덱싱 과정에서 청크에서 누락 | 21 | 인덱싱 결함. 다음 글에서 설명 |
문서 자체를 검색하지 못한 경우를 추적한 결과 대부분 두 번째 문서였습니다. 예를 들어 “썸네일 재생성 API에 넣는 이미지 ID는 어디에서 확인하는가”라는 질문의 답은 이미지 목록 API 문서의 응답 필드에 있습니다. 하지만 질문에는 “이미지 목록 API”라는 단어가 없으므로 질문으로 검색하면 이 문서가 검색되지 않습니다. 같은 문서를 제목으로 검색하면 1위로 검색되었으므로 청크 자체의 문제는 아니었습니다.
그래서 Agentic 검색의 후속 검색어를 확인해봤는데, 대부분 원래 질문을 다른 표현으로 바꾼 것이었습니다. 이는 질문 검색 후 청크를 보고 필요한 질문을 다시 하는 의도와 다르게, 같은 질문을 여러번 반복하는 현상이었습니다. 첫 검색 결과에서 새로 알게 된 문서명이나 API명으로 다시 검색하는 경우는 드물었습니다.
이러한 현상이 검색을 일찍 종료하는것도 원인은 아니었습니다.
| 도구 호출 수 | 실행 | All Evidence | Correctness |
|---|---|---|---|
| 1회 이하 | 36 | 0.89 | 0.99 |
| 3회 이하 | 116 | 0.78 | 0.93 |
| 6회 이상 | 66 | 0.68 | 0.82 |
어려운 문항일수록 검색을 더 많이 하지만 같은 방향의 검색을 반복하다 결국 근거를 찾지 못했습니다.
또한 필요한 청크 바로 옆에서 검색을 멈추는 경우도 많았습니다.
expand는 240회 실행 중 60회에서만 사용되었습니다.
작성 단계 오류
근거를 모두 받고도 정답이 아닌 경우는 세 가지였습니다.
- 근거에 있는 세부 사실 누락: 답변에 필요한 조건이나 엔드포인트를 빠뜨림
- 비슷한 문서와 이전 버전 문서 혼용: 다른 시스템의 절차나 이전 버전의 동작을 현재 동작처럼 서술
- 계산과 결론 오류: 근거의 수치를 잘못 계산하거나 결론의 우선순위를 잘못 제시
두 원인에 대응해 조사 단계와 작성 단계를 차례로 개선했습니다.
조사 단계 개선
근거 누락을 줄이기 위해 조사 단계에 두 가지 개선을 차례로 적용했습니다. 두 개선의 효과가 인덱스 상태와 관계없이 나타나는지 확인하기 위해 인덱싱 개선 전 데이터와 인덱싱 개선 데이터에서 각각 3회씩 측정했습니다.
① 후속 검색 원칙
조사 모델의 지시문에 다음 원칙을 추가했습니다.
1
2
3
후속 검색은 원래 질문을 다시 쓰지 말고 결과가 가리키는 이름으로 한다.
검색 결과에서 새로 알게 된 문서명 / API명 / 테이블명으로 다시 찾는다.
질문을 다른 표현으로 바꾼 검색은 한 번까지만 한다.
측정 결과: 초기 Agentic RAG와 비교
| 지표 | 인덱싱 개선 전 데이터: 초기 버전 | ① 적용 | 인덱싱 개선 데이터: 초기 버전 | ① 적용 |
|---|---|---|---|---|
| Correctness | 0.881 | 0.908 | 0.877 | 0.898 |
| All Evidence | 0.683 | 0.704 | 0.717 | 0.721 |
| Faithfulness | 0.860 | 0.890 | 0.885 | 0.894 |
| 실행 비용 (달러) | 0.71~0.73 | 0.71~0.74 | 0.72~0.74 | 0.75~0.79 |
두 데이터 모두 Correctness가 0.02~0.03 상승했습니다. 두 데이터의 문항별 Correctness를 짝지어 부호 검정을 수행한 결과 상승 33문항 대 하락 19문항(p=0.07)으로 방향은 일관되지만 통계적으로 확정할 수준은 아니었습니다.
그런데 겨냥했던 “문서 자체를 검색하지 못함”은 46건에서 45건으로 거의 줄지 않았습니다. 근거를 찾지 못한 문항을 다시 추적한 결과, 첫 결과가 다음 문서의 이름을 알려 주는 문항에서는 원칙대로 이름을 따라 검색해 두 번째 문서를 찾았습니다. 그러나 대부분의 문항은 필요한 문서의 이름이 첫 결과에 없었으므로 따라갈 이름이 없었습니다. Correctness의 상승은 주로 같은 문서 안의 근거를 더 많이 수집한 문항에서 발생했습니다. 비용은 인덱싱 개선 전 데이터에서는 같았고 인덱싱 개선 데이터에서는 약 5% 증가했습니다.
② 앞뒤 청크 자동 추가
원인 분석에서 “필요한 청크가 없음” 47건 중 30건은 이미 받은 청크에서 2칸 이내에 있었습니다. 그래서 조사가 끝나고 작성 모델에게 근거를 전달하기 전에 앞뒤 청크를 자동으로 추가했습니다.
1
2
3
4
5
seeds = pick_expand_seeds(results, max_docs=5, seeds_per_doc=2)   # 상위 문서별 유사도 상위 청크
for chunk_id, scope in seeds:
    # expand 도구를 그대로 사용하므로 권한 조건도 그대로 적용
    out = await call_tool("expand", chunk_id=chunk_id, before=1, after=1, scope=scope)
    added += [c for c in out["chunks"] if c["chunk_id"] not in seen]
앞뒤 청크를 조회할 기준 청크는 다음 순서로 선택합니다.
- 조사 중에 받은 청크를 문서별로 묶습니다.
- 문서마다 소속된 청크의 최대 유사도 값을 구하고, 구한 유사도 값이 가장 높은 상위 문서 5개를 선택합니다.
- 선택한 문서마다 유사도가 가장 높은 청크 2개를 기준 청크로 정합니다.
- 기준 청크마다
expand로 바로 앞 청크와 바로 뒤 청크를 하나씩 조회합니다.
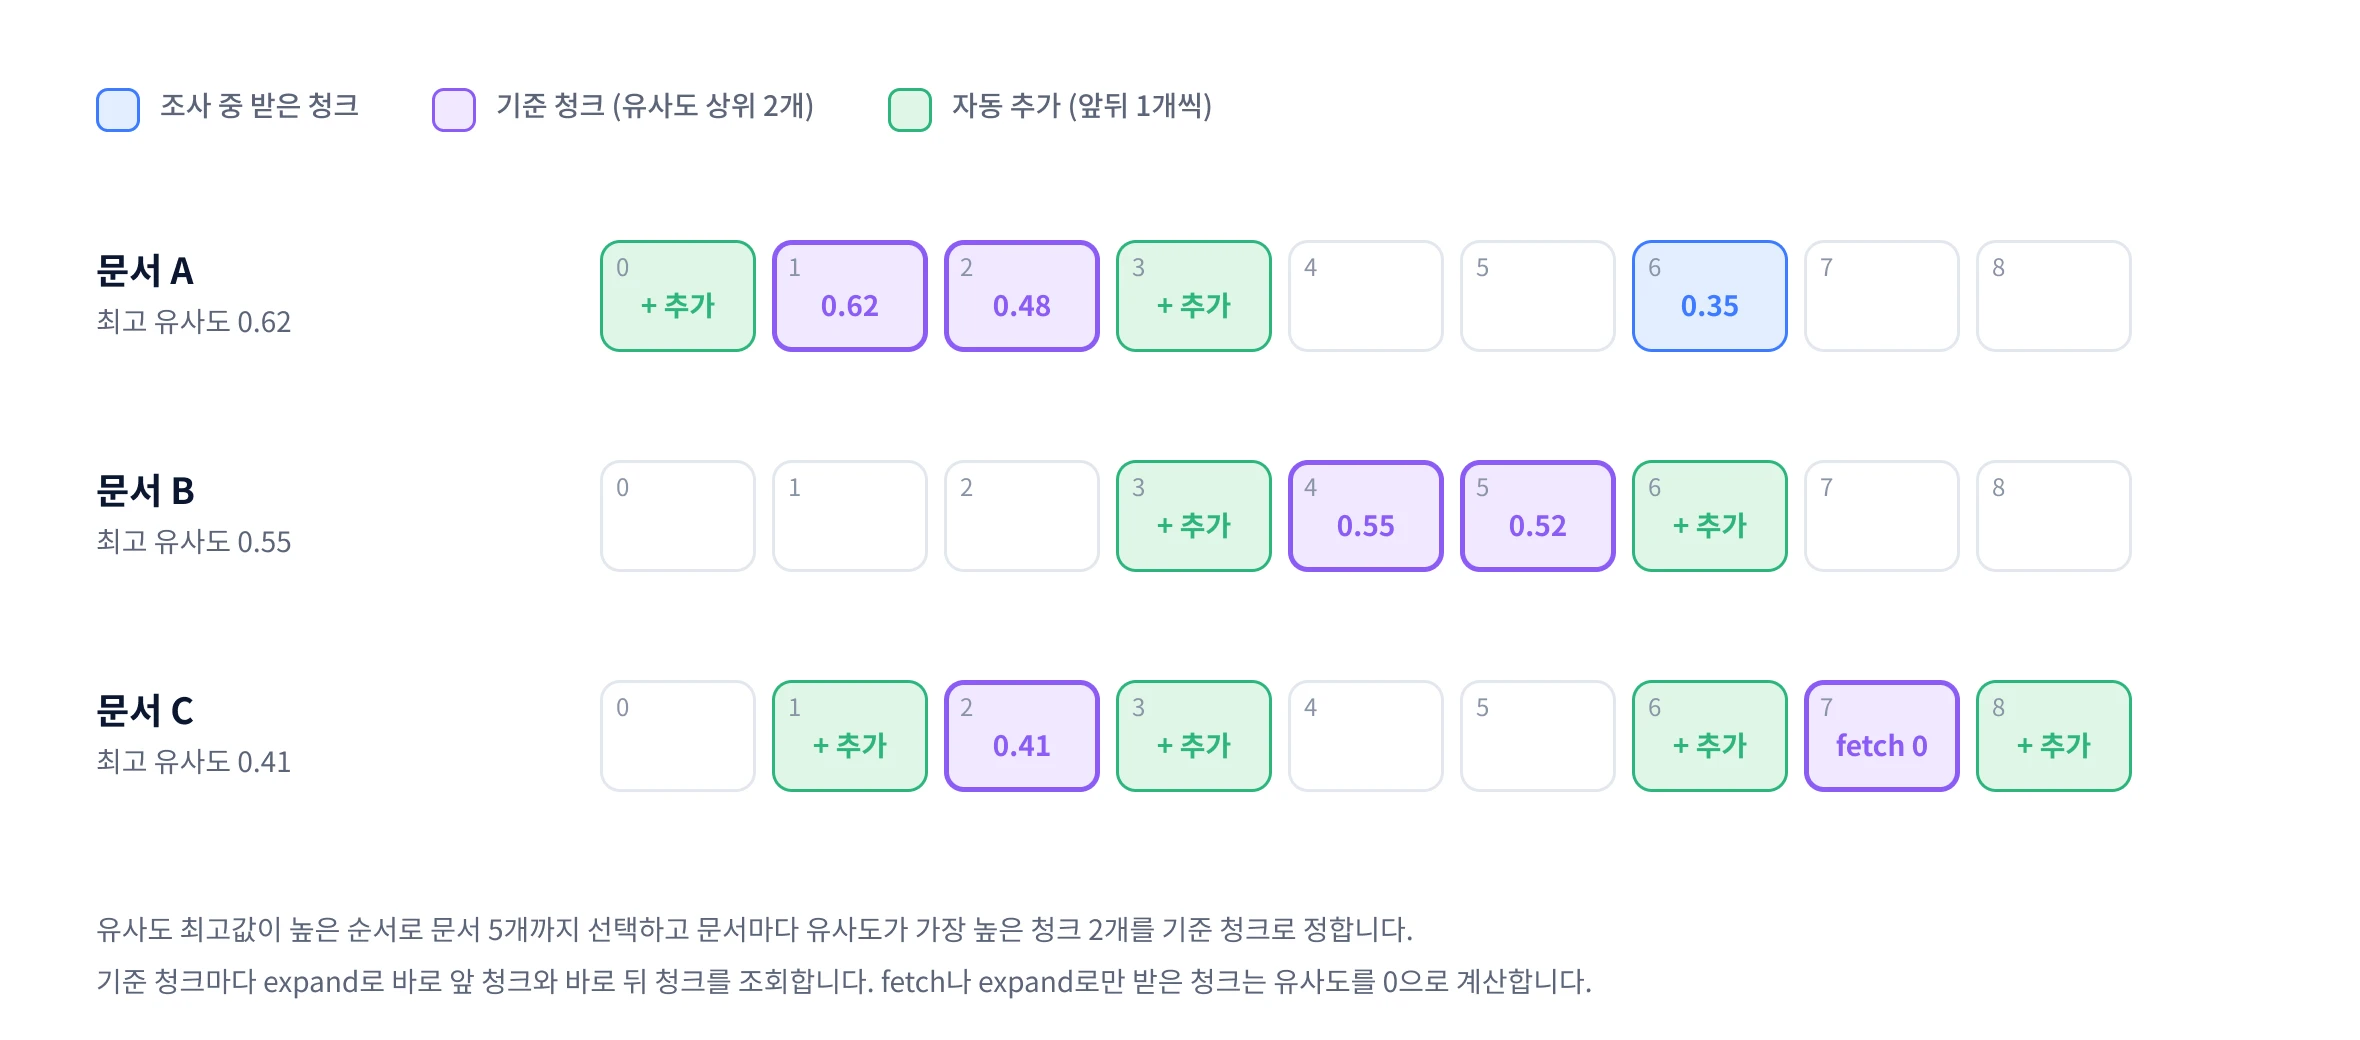
따라서 한 문항에서 기준 청크는 최대 10개이고 새로 추가되는 청크는 최대 20개입니다.
이미 받은 청크와 겹치는 청크는 인계 단계에서 하나로 합칩니다.
fetch나 expand로만 받은 청크는 유사도가 없으므로 0으로 계산했습니다.
한 문항에서 조회 시간은 1초 미만이었습니다.
측정 결과: ①과 비교
| 지표 | 인덱싱 개선 전 데이터: ① | ①+② | 인덱싱 개선 데이터: ① | ①+② |
|---|---|---|---|---|
| Correctness | 0.908 | 0.910 | 0.898 | 0.904 |
| All Evidence | 0.704 | 0.796 | 0.721 | 0.821 |
| Faithfulness | 0.890 | 0.887 | 0.894 | 0.879 |
| 실행 비용 (달러) | 0.71~0.73 | 0.80 | 0.75~0.79 | 0.82~0.85 |
| 작성 모델 근거 길이 (중앙값) | 3.4만 자 | 4.6만 자 | 3.4만 자 | 4.3만 자 |
All Evidence는 두 데이터 모두 약 0.1 상승했고 3회 측정 범위도 겹치지 않았습니다. 인덱싱 개선 데이터에서 근거 누락 원인을 다시 분류하면 “필요한 청크가 없음”은 38건에서 15건으로 감소했고 “본문이 잘림”은 12건에서 4건으로 감소했습니다.
그러나 Correctness는 ①과 거의 같았습니다(상승 25문항 대 하락 24문항 / p=1.0). 또한 근거가 3.4만 자에서 4.3만 자로 길어지면서 근거를 모두 받고도 정답이 아닌 답변이 8건에서 18건으로 늘었습니다. 비용은 작성 모델의 입력이 늘어난 만큼 8~12% 증가했습니다.
초기 Agentic RAG와 비교하면 ①과 ②를 함께 적용한 효과는 상승 35문항 대 하락 15문항(p=0.007)으로 우연으로 판단하기 어렵습니다. 다만 Correctness에 대한 기여는 대부분 ①에서 발생했고 ②는 근거 수집을 개선했지만 그 효과가 정답으로 이어지지 않았습니다. 결국 남은 병목은 작성 단계였습니다.
작성 단계 개선
작성 단계만 변경하는 개선은 이전 측정에서 저장해둔 검색 결과 240건을 다시 활용해, 작성 모델만 재측정하는 방식으로 진행했습니다. 조사 단계의 검색 결과는 실행할 때마다 달라지므로 이 변동을 제거해야 작성 단계의 차이만 비교할 수 있기 때문입니다. 같은 근거로 작성 모델만 다시 실행해도 240회 중 19회의 판정이 달라졌으므로 이 정도의 차이는 작성 모델 자체의 변동으로 판단했습니다. 조사 단계가 함께 바뀌는 개선은 전체 질의를 다시 실행했습니다. 아래 측정은 모두 인덱싱 개선 데이터에서 ①+②를 적용한 상태를 기준으로 진행했습니다.
③ 유사도 하위 근거 제외
작성 모델에게 전달하는 근거의 83%는 조사 중 여러 번 검색하면서 누적된 검색 결과 발췌였습니다.
그러나 작성 모델이 실제로 인용한 비율은 검색 발췌가 21%이고 fetch와 expand로 받은 청크가 38%였습니다.
그래서 검색 발췌를 검색 요청 안의 유사도 순위로 정렬해 하위 일부를 제외하는 규칙을 도입했습니다.
이때 fetch와 expand로 받은 청크와 요청별 상위 3개 청크는 항상 유지했습니다.
| 규칙 | 제거되는 근거 글자 | 잃는 정답 인용 |
|---|---|---|
| 요청별 하위 30% | 26% | 0 |
| 요청별 하위 50% | 43% | 0 |
| 유사도 0.45 미만 | 48% | 1 |
| 최고값의 80% 미만 | 61% | 35 |
정답 인용이 포함된 발췌는 모두 요청 안에서 유사도 상위 30% 안에 있었습니다. 그러므로 요청별 하위 50%를 제외해도 정답 인용은 하나도 사라지지 않으므로 이 규칙을 적용했습니다.
측정 결과: ①+②와 비교
| 지표 | ①+② (전체 근거) | ③ 적용 (하위 50% 제외) |
|---|---|---|
| Correctness | 0.910 | 0.910 |
| Faithfulness | 0.877 | 0.887 |
| 작성 모델 입력 토큰 (중앙값) | 23,322 | 13,300 |
| 작성 1건 비용 | 0.0068달러 | 0.0047달러 (−32%) |
| 작성 시간 (중앙값) | 11.6초 | 11.8초 |
Correctness는 같았고 짝 비교에서도 상승 8회 대 하락 8회(p=1.0)로 차이가 없었습니다. 반면 작성 비용은 32% 감소했고 실행 전체 비용으로 환산하면 약 20% 감소입니다. ②로 늘어난 비용(8~12%)보다 감소 폭이 크므로 ②의 비용 증가를 상쇄했습니다.
결론적으로 답변 생성 성능 자체에는 영향이 없었지만, 비용을 32%나 줄일 수 있었기때문에 적용했습니다.
효과가 없었던 지시문 변경
작성 단계의 오류를 줄이기 위해 작성 모델의 지시문에 다음 두 가지를 추가했습니다.
- 질문 항목 체크리스트: 답변을 작성하기 전에 질문이 묻는 대상과 조건을 항목으로 나누고, 항목마다 근거를 찾은 뒤 마지막에 모두 답변했는지 확인
- 대상과 시점 규칙: 질문이 지목한 시스템과 버전을 먼저 확정하고, 다른 시스템이나 이전 버전 문서는 배경으로만 사용
측정 결과: ③과 비교
| 지표 | ③ | ③ + 지시문 변경 |
|---|---|---|
| Correctness | 0.910 | 0.910 |
| Must-have All | 0.838 | 0.838 |
| Faithfulness | 0.887 | 0.894 |
짝 비교에서도 상승 9회 대 하락 9회로 차이가 없었으므로 적용하지 않았습니다. 반복해서 틀리던 문항은 지시문이 있어도 같은 조건을 빠뜨렸습니다. 이를 근거로 지시가 없어서 생긴 문제가 아니라 작성 모델이 긴 근거에서 특정 조건을 놓치는 문제로 판단했습니다.
④ 조사 모델의 인계 메모
작성 모델에게 지시를 추가하는 방식은 효과가 없었으므로, 근거를 가장 많이 확인한 조사 모델이 작성 모델에게 직접 근거의 위치를 인계 메모로 알려주는 방식을 검토했습니다. 기존 구조에서는 조사 모델이 조사를 마치면 “조사 완료”만 출력했습니다. 이를 다음 형식의 인계 메모로 바꾸고 작성 모델에게 전달하는 근거의 맨 앞에 추가했습니다.
1
2
3
4
5
6
## 조사 담당 메모
- 질문 대상: 질문이 지목한 시스템과 버전
- 항목별 근거: 질문 항목마다 답이 있는 청크 ID와 핵심 사실 한 줄
- 시점: 현행 문서와 이전 문서의 판단과 그 근거
- 상충: 근거끼리 다른 내용
- 찾지 못한 것
작성 모델에게는 메모는 참고로만 사용하고 사실은 반드시 청크 본문에서 확인하라는 규칙을 함께 제공했습니다. 조사 단계가 함께 바뀌므로 이 개선은 전체 질의를 3회 다시 실행했습니다.
측정 결과: ③과 비교
| 지표 | ③ (3회) | ④ 적용 (3회) |
|---|---|---|
| Correctness | 0.908 (0.906~0.912) | 0.925 (0.906~0.963) |
| Must-have All | 0.829 | 0.863 |
| Faithfulness | 0.908 (0.887~0.931) | 0.956 (0.938~0.988) |
| 근거 밖 서술 (3회 합계) | 41건 | 20건 |
| All Evidence | 0.808 | 0.842 |
| 평균 도구 호출 | 4.6~4.7회 | 5.0~5.2회 |
| 실행 비용 (80문항) | 0.66~0.68달러 | 0.69~0.71달러 |
근거 밖 서술은 41건에서 20건으로 절반이 되었고 Faithfulness는 3회 모두 ③의 최고값보다 높았습니다. Correctness는 평균 0.017 상승했지만 상승 14문항 대 하락 9문항(p=0.41)으로 유의미 하지 않았습니다. 조사 모델이 메모 형식을 알고 조사하면서 도구 호출이 약 0.4회 늘었고 그만큼 비용이 4% 증가했습니다.
다만 부작용이 두 가지 있었습니다.
- 조사 모델의 시점 판단 오류가 전파됨: 두 문서 중 어느 쪽이 현행인지 조사 모델이 잘못 판단하면 작성 모델도 그 판단을 그대로 따름
- 메모가 빠뜨린 근거는 작성 모델도 놓침: 근거에 자료가 있어도 메모가 언급하지 않으면 답변에 반영하지 않음
첫 번째 부작용을 줄이기 위해 자료로 선후를 판단할 수 없으면 단정하지 말고 “판단 불가”와 후보 문서를 기재하게 했습니다. 그리고 메모에 기재된 청크 ID 중 실제 근거에 없는 ID가 기재되는 환각이 일부(평균 1.6%) 발생했는데, 이는 작성 모델에게 전달하기 전에 “근거에 없는 청크”로 표시했습니다. 두 번째 부작용은 일단은 모델 성능상 한계로 보고 개선하지 않았습니다.
⑤ 문서 작성일과 수정일
시점 판단이 틀린 문항을 확인한 결과, 두 문서 어디에도 어느 쪽이 나중에 작성되었는지 알 수 있는 정보가 없었습니다. 인덱스에는 문서의 버전 번호와 인덱싱 시각만 저장되어 있었습니다. 하지만 이는 명확한 작성 시각이 아니라서 최신 정보를 판단하는데 사용하기는 어려웠습니다.
그래서 위키 문서의 작성일과 최종 수정일을 문서 메타데이터로 저장하고, 검색 결과와 작성 단계 근거의 문서 앞부분에 표시했습니다. 청크 본문이 아니라 메타데이터에 저장했으므로 재인덱싱이나 LLM 비용은 발생하지 않았습니다. 기존 문서 1,038건의 날짜는 위키 API로 한 번에 저장했고 이후에 인덱싱하는 문서는 인덱싱할 때 날짜를 갱신합니다.
측정 결과: ④와 비교
| 지표 | ④ (3회) | ⑤ 적용 (2회) |
|---|---|---|
| Correctness | 0.925 (0.906~0.963) | 0.922 (0.919~0.925) |
| Faithfulness | 0.956 | 0.947 |
| 근거 밖 서술 major (회당) | 0.3건 | 0건 |
| 실행 비용 (80문항) | 0.69~0.71달러 | 0.73~0.75달러 |
| 시점 판단 문항 | 3회 중 1회 정답 | 2회 모두 정답 |
전체 Correctness는 ④와 같은 수준이었고 차이는 실행 간 변동 범위 안이었습니다. 날짜의 효과는 시점을 판단해야 하는 문항에서 나타났습니다. 날짜를 추가한 뒤에는 조사 메모가 날짜 순서로 문서를 정렬했고 2회 측정 모두 현행 문서를 기준으로 답변했습니다. 반면 검색 결과마다 날짜 필드가 추가되면서 조사 입력이 늘어 비용은 약 5% 증가했습니다.
최종 성능
①~⑤를 모두 적용한 최종 구조를 베이스라인과 같은 데이터에서 2회 측정했습니다.
먼저 검색 지표를 베이스라인인 단일 검색 RAG와 비교했습니다.
| 지표 | 베이스라인 (5회) | 초기 Agentic RAG (3회) | 최종 (2회) |
|---|---|---|---|
| Doc Hit | 0.978 | 1.000 | 1.000 |
| All Docs | 0.595 | 0.925 | 0.925 |
| Evidence Recall | 0.604 | 0.885 | 0.946 |
| All Evidence | 0.273 | 0.683 | 0.825 |
| 문항당 확인한 청크 | 10개 | 평균 약 40개 | 평균 약 28개 |
All Evidence는 베이스라인의 0.273에서 0.825로 약 3배가 되었습니다. 초기 Agentic RAG와 비교해도 0.142 상승했습니다. 작성 단계로 전달하는 청크는 하위 근거 제외 덕분에 평균 약 40개에서 약 28개로 오히려 줄었습니다. 결과적으로 더 적은 청크로 필요한 근거를 더 많이 수집했습니다.
베이스라인은 답변을 생성하지 않았으므로 답변 지표는 초기 Agentic RAG와 비교했습니다.
| 지표 | 초기 Agentic RAG (3회) | 최종 (2회) | 변화 | 문항별 상승 / 하락 |
|---|---|---|---|---|
| Correctness | 0.881 | 0.925 | +0.044 | 22 / 7 (p=0.008) |
| Must-have All | 0.796 | 0.863 | +0.067 | - |
| Faithfulness | 0.860 | 0.959 | +0.099 | 35 / 7 (p<0.001) |
| All Evidence | 0.683 | 0.825 | +0.142 | 26 / 8 (p=0.003) |
| 실행 비용 (80문항) | 0.71~0.73달러 | 0.68~0.69달러 | 약 −5% | - |
Correctness는 0.044 상승했고 Faithfulness와 All Evidence는 각각 0.099와 0.142 상승했습니다. 세 지표 모두 문항 단위의 부호 검정에서 유의했으므로 측정할 때마다 생기는 변동이 아니라 개선의 효과로 판단했습니다.
유형별 Correctness는 다음과 같습니다.
| 유형 | 문항 | 초기 Agentic RAG (3회) | 최종 (2회) | 변화 | 문항별 상승 / 하락 |
|---|---|---|---|---|---|
단일 (single) |
10 | 1.000 | 1.000 | 0.000 | 0 / 0 |
연쇄 (bridge) |
16 | 0.865 | 0.953 | +0.089 | 5 / 0 |
비교 (comparison) |
11 | 0.848 | 0.841 | −0.008 | 3 / 3 |
열거/집계 (aggregation) |
9 | 0.796 | 0.917 | +0.120 | 4 / 0 |
수치 계산 (numeric) |
9 | 0.944 | 0.972 | +0.028 | 1 / 1 |
규칙 적용 (rule_application) |
9 | 0.870 | 0.889 | +0.018 | 3 / 1 |
원인 진단 (causal) |
9 | 0.889 | 0.944 | +0.056 | 3 / 1 |
변경/시점 추적 (temporal) |
7 | 0.833 | 0.857 | +0.024 | 3 / 1 |
초기 Agentic RAG에서 가장 낮았던 열거/집계 유형(0.796 → 0.917)과 문항이 가장 많은 연쇄 유형(0.865 → 0.953)이 가장 크게 상승했고 두 유형 모두 하락한 문항이 없었습니다. 비교 유형은 상승한 문항과 하락한 문항이 각각 3개로 변화가 없었습니다.
비용은 오히려 초기 Agentic RAG보다 약 5% 감소했습니다. 앞뒤 청크 자동 추가와 인계 메모와 문서 날짜는 비용을 늘렸지만 하위 근거 제외가 작성 비용을 32% 줄여 증가분을 상쇄했기 때문입니다.
정리
단일 검색 RAG는 첫 번째 문서는 찾았지만 여러 문서에 걸친 근거를 모두 찾지 못하는 문제가 있었습니다. 그래서 LLM이 직접 충분한 근거를 모을때까지 검색을 반복하는 Agentic RAG를 구현하고, 개선된 평가셋으로 측정하면서 다음 순서로 개선했습니다.
- 구조: 청크 단위로 결과를 반환하는 도구 4개(
outline/search/fetch/expand)를 제공하고 조사 모델과 작성 모델을 분리 - 비용: 이미 확인한 청크의 본문 생략과 조사 모델의 추론 강도 하향
- 조사 단계: 후속 검색 원칙과 앞뒤 청크 자동 추가
- 작성 단계: 유사도 하위 근거 제외와 조사 모델의 인계 메모와 문서 작성일 및 수정일 제공
최종 구조는 단일 검색 RAG보다 필요한 근거를 모두 찾은 문항의 비율(All Evidence)이 0.273에서 0.825로 약 3배가 되었습니다. 초기 Agentic RAG와 비교하면 Correctness는 0.881에서 0.925로 상승했고 Faithfulness는 0.860에서 0.959로 상승했으며 비용은 약 5% 감소했습니다. 개선 효과가 측정할 때마다 생기는 변동인지 구분할 수 있었던 이유는 지난 글의 평가셋으로 문항 단위의 변화를 비교했기 때문입니다.
다음 글에서는 이번 글에서 여러 번 언급한 인덱싱 개선을 다룹니다. 인덱싱 개선 후 전체 검색 성능은 상승했지만 Agentic RAG의 Correctness는 거의 변하지 않았고 일부 유형은 오히려 하락했습니다. 그 원인을 추적하면서 발견한 청킹 결함과 해결 과정을 정리하겠습니다.