
개요
이번 글에서는 RAG 시스템의 핵심 저장소로 채택한 두 데이터베이스 기술인 Qdrant와 Neo4j에 대해 내용입니다. 앞선 글들에서는 RAG 자체의 기능, 구현 방법에 대해 설명했는데, 이 데이터들을 어떤 식으로 저장하고 관리하는지는 구체적으로 다루지 않아서 이에 대해 정리해보고자 합니다. 이 글에서는 RAG가 다루는 데이터 구조를 간단히 알아보고, 두 데이터베이스가 내부적으로 어떻게 동작하는지와 왜 많은 후보 중 Qdrant와 Neo4j를 선택했는지를 중심으로 살펴본 뒤 실제 적용 기능을 설명할 예정입니다.
RAG에서 다루는 데이터의 형태
현재 구현된 RAG 시스템은 Vector와 Graph를 동시에 활용하는 하이브리드 RAG로, 성격이 다른 세 타입의 데이터를 저장합니다.
| 데이터 구분 | 저장소 | 저장 내용 | 조회 방식 |
|---|---|---|---|
| 청크 검색 | VectorDB (Qdrant) | - 3,072차원 임베딩 Dense 벡터 - BM25 Sparse 벡터 - 메타데이터 페이로드 |
의미 유사도와 키워드 점수의 하이브리드 검색 및 권한 필터링 |
| KG | VectorDB + GraphDB (Neo4j) | - VectorDB에 엔티티와 관계 임베딩 - GraphDB에 노드와 엣지 구조 및 근거 청크 ID 목록 |
벡터 검색으로 탐색 시작점을 찾고 그래프에서 연결 맥락과 원문 청크 추적 |
| 원본 및 운영 | RDB (PostgreSQL) | - 문서 인덱싱 상태 - 원문 텍스트 캐시 - 계정 매핑 - 이벤트 큐 - 질의 로그 |
트랜잭션 보장과 정규화된 관계형 조인 |
즉 하나의 문서가 색인되면 의미와 키워드 검색용 청크는 벡터 DB로, 문서에서 추출한 개체와 관계는 Knowledge Graph(KG) 로 구성해 탐색 진입점(벡터 DB)과 연결 구조(그래프 DB)로 구분해 저장합니다. 단순 상태 관리와 로그는 기존 관계형 DB에 남기므로 두 저장소는 각각 고차원 유사도 연산과 그래프 연결 탐색에만 활용됩니다.
Qdrant: 아키텍처와 핵심 기능 및 선정 이유
Qdrant는 Rust로 작성된 오픈소스 벡터 데이터베이스로, 고성능 벡터 검색 엔진입니다. 메모리 안정성과 낮은 응답 시간이 장점이며, 대규모 고차원 벡터 검색과 복잡한 메타데이터 필터링을 함께 처리하도록 설계되었습니다.
1. 논리 데이터 모델: 컬렉션 / 포인트 / 벡터와 페이로드
Qdrant의 논리 구조는 컬렉션 → 포인트 → ID / 벡터 / 페이로드 구조로 이어집니다. RDB의 테이블 → 행 → 컬럼 구조에 대응한다고 생각하면 됩니다.
-
컬렉션(Collection): 스키마가 정의되는 최상위 논리 공간입니다. 벡터 차원 / 거리 계산 함수(
Cosine/Dot/Euclid/Manhattan) / HNSW와 양자화 설정 / Named Vectors 슬롯 구성이 모두 컬렉션 단위로 지정됩니다. RDB의 테이블에 비유할 수 있습니다. -
포인트(Point): 컬렉션 안에서 검색과 갱신의 대상이 되는 기본 레코드입니다. 각 포인트는 고유 식별자(64비트 부호 없는 정수 또는 UUID)와 벡터 및 선택적 페이로드를 함께 보관합니다. RDB의 행(row)에 비유할 수 있습니다.
-
벡터(Vector)와 페이로드(Payload): 하나의 포인트를 채우는 데이터 필드입니다. 벡터 필드에는 임베딩 모델이 만든 Dense 벡터뿐만 아니라 단어 빈도 가중치를 담는 Sparse 벡터, 토큰 단위 다중 벡터(Multi-vector)를 저장합니다. 페이로드 필드는 원문 텍스트나 태그 및 접근 권한 같은 JSON 메타데이터를 보관하며 검색 시 필터 조건으로 활용됩니다. RDB의 필드(field)에 비유할 수 있습니다.
2. 물리 저장 및 분산 구조: 컬렉션 / 샤드 / 세그먼트
물리 구조는 컬렉션 → 샤드 → 세그먼트 순으로 이어집니다.
1
2
3
4
Collection (독립 저장소 경계 / 샤드 구성 단위)
 └── Shard (수평 분할 / 복제 단위)
      ├── WAL     : 쓰기 영속성과 장애 복구용 순차 로그
      └── Segment : 벡터 / 페이로드 파일 및 HNSW / 역색인 저장 단위
-
컬렉션(Collection): 물리 저장소에서도 컬렉션은 독립된 저장 디렉터리와 설정으로 관리됩니다. 컬렉션 생성 시 샤드 개수와 복제 계수가 정해지며, 하위의 모든 샤드를 묶어 하나의 검색 대상으로 관리합니다.
-
샤드(Shard): 컬렉션을 수평 분할하는 분산/복제 단위입니다. 각 샤드는 전체 포인트를 겹치지 않게 분할하여 보관합니다. 노드 간 복제본(Replica)을 생성해 데이터의 안정성을 높일 수도 있습니다. 또한 샤드마다 장애 복구용 로그 WAL(Write-Ahead Log)을 기록해 삽입이나 삭제 요청을 먼저 WAL에 기록한 뒤, 세그먼트에 반영합니다. 그래서 비정상 종료 시에도 재시작 과정에서 로그를 재실행(Replay)해 유실을 방지합니다.
-
세그먼트(Segment)와 Copy-on-Write: 하나의 샤드 내부에는 실제 저장과 색인이 이루어지는 여러 세그먼트가 존재합니다. 각 세그먼트는 저장 및 색인 요소(벡터 스토리지 / 페이로드 스토리지 / HNSW 및 페이로드 역색인 / ID 매퍼)를 자체적으로 저장합니다. Qdrant는 쓰기 속도를 높이기 위해 가변(Appendable) 세그먼트에 새 포인트를 먼저 쌓고, 일정 규모를 넘으면 HNSW 그래프를 구축해 불변(Non-appendable) 세그먼트로 전환합니다.
그리고 검색 요청이 샤드에 도달하면 모든 세그먼트를 병렬 조회한 뒤 결과를 합쳐 반환하는 알고리즘으로 검색 속도도 높입니다. 또한 이미 색인된 불변 세그먼트의 포인트를 수정하거나 페이로드만 갱신해도 대상 포인트를 직접 수정하지 않고, 기존 포인트에 삭제 표시를 남긴 뒤 벡터와 페이로드 전체를 새 세그먼트에 복사해 기록합니다(Copy-on-Write). 이후 백그라운드 옵티마이저(Optimizer)가 작은 세그먼트를 병합하고 삭제 표시된 공간을 회수합니다. 이는 수정 중 검색 Lock을 방지하기 위함입니다.
3. 핵심 검색 기술과 기능
HNSW(Hierarchical Navigable Small World)
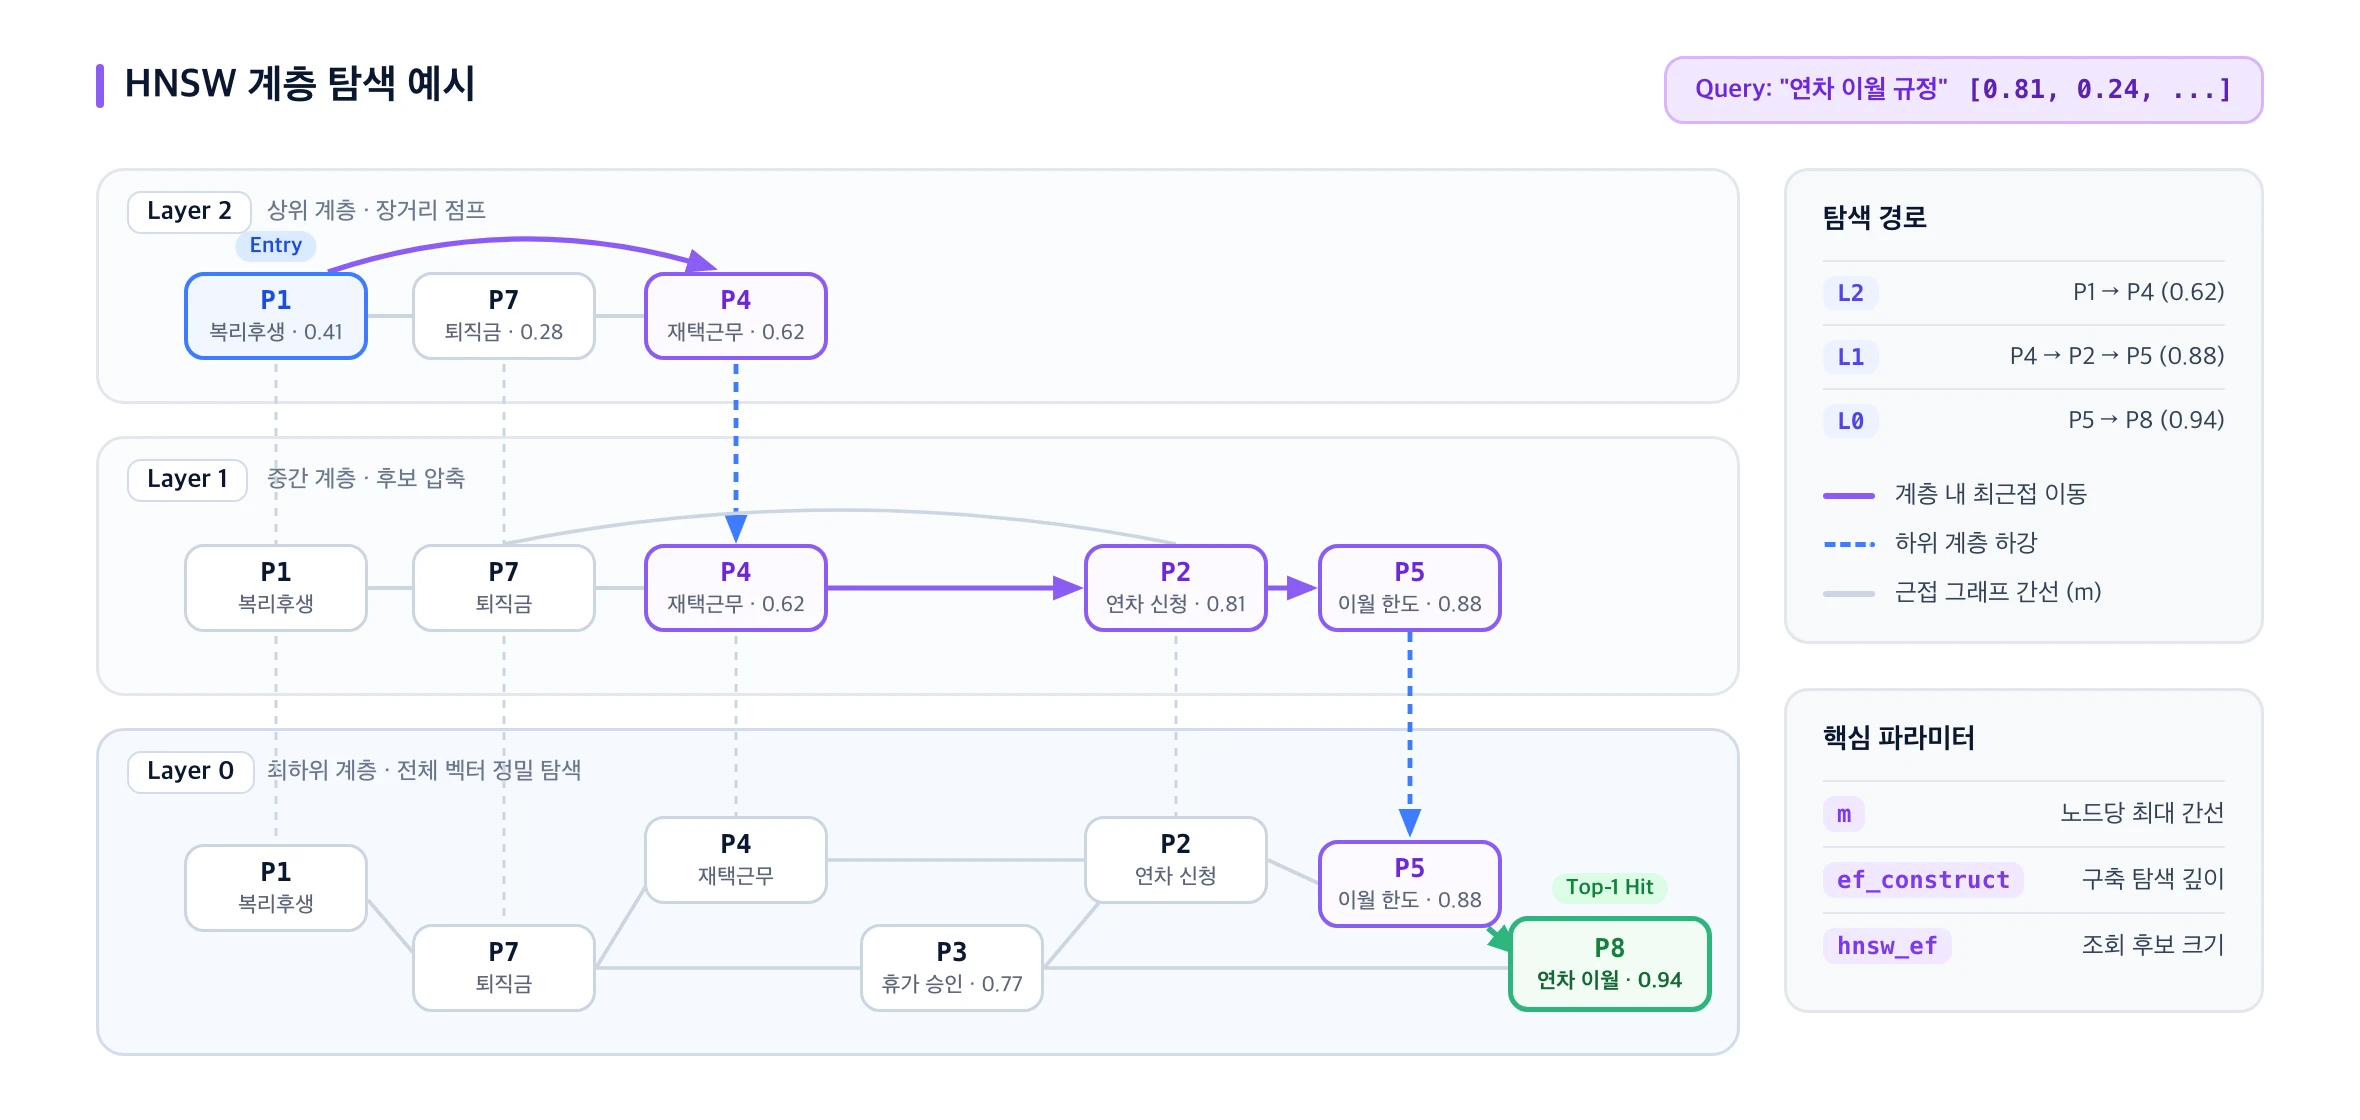
수만 개 이상의 고차원 벡터에서 질문과 가까운 데이터를 찾을 때, 매번 전체 벡터와 거리를 계산하는 전수 스캔($O(N)$)을 수행하면 응답 시간이 길어집니다. Qdrant는 이를 해결하기 위해 근사 최근접 이웃(ANN) 탐색 알고리즘인 HNSW를 핵심 벡터 인덱스로 사용합니다.
HNSW는 계층적 탐색 구조인 스킵 리스트(Skip List)와 근접 그래프를 결합한 인덱스입니다.
- 상위 계층: 적은 수의 대표 노드가 먼 거리를 잇는 간선으로 연결되어 있어 질의 벡터 근처 영역으로 빠르게 이동합니다.
- 하위 계층: 아래로 내려갈수록 노드 밀도가 촘촘해지며 모든 노드가 포함된 최하위 계층에서 정밀하게 최종 이웃 벡터를 찾습니다.
덕분에 탐색 범위가 크게 줄어들어 대규모 데이터에서도 $O(\log N)$ 수준의 속도로 유사 벡터를 검색합니다. 이때 Qdrant는 세 가지 HNSW 설정으로 그래프 품질과 메모리 및 속도의 균형을 조절할 수 있습니다.
-
m: 노드당 유지하는 최대 연결 간선 수(기본 16)입니다. 값이 클수록 재현율(Recall) 이 높아지지만 RAM 점유율과 색인 시간이 늘어납니다. -
ef_construct: 인덱스를 구축할 때 이웃 연결 후보를 탐색하는 깊이입니다. 값이 높을수록 정교한 그래프가 만들어지지만 삽입 속도는 느려집니다. -
hnsw_ef: 검색 시점에 방문할 후보 목록 크기입니다. 인덱스를 재구축하지 않고도 질의 요청마다 검색 정확도와 응답 시간의 균형을 조절합니다.
Filterable HNSW와 쿼리 플래너
HNSW 그래프 위에 메타데이터 필터 조건까지 함께 적용하면 일반적인 벡터 검색에서는 두 가지 문제가 발생합니다.
-
검색 후 필터링(Post-filtering): 먼저 벡터 유사도로 상위 후보를 뽑은 뒤 조건을 거르면 조건에 맞는 문서 비중이 작을 때 최종 결과가 목표 개수보다 적어집니다.
-
검색 전 필터링(Pre-filtering): 조건에 맞는 데이터만 먼저 추리면 기존 HNSW 그래프의 연결 경로가 끊어져 탐색 정확도가 하락합니다.
Qdrant는 페이로드 필드에 역색인 기반 페이로드 인덱스를 구축하고, HNSW 그래프 내부에 조건을 만족하는 이웃 간 추가 연결을 유지하는 Filterable HNSW 방식으로 이 문제를 해결합니다. 여기에 쿼리 플래너가 필터 조건에 통과하는 데이터 Cardinality를 추정해 대상이 극소수면 HNSW 그래프 대신 정확한 전수 스캔으로 자동 전환해 속도와 정확도를 모두 지킵니다.
Named Vectors / Sparse 벡터 / 서버사이드 IDF / RRF
하나의 포인트 = 하나의 벡터가 기본이지만, 필요에 따라 하나의 포인트에 여러 벡터를 각각 이름을 붙여 저장할 수 있습니다. 이를 Named Vectors라고 합니다. 그래서 임베딩한 Dense 벡터와 BM25의 Sparse 벡터를 별도 저장소로 분리하지 않고 한 포인트 안에 묶어 관리할 수 있습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 1) 단일 벡터 방식 (1 포인트 = 1 벡터)
models.PointStruct(
    id="...",
    vector=[0.012, -0.041, ...],  # 이름 없는 단일 벡터
    payload={"entity_name": "Redis", "acl_open": True},
)

# 2) Named Vectors 방식 (1 포인트 = 여러 벡터 슬롯)
models.PointStruct(
    id="...",
    vector={
        "dense": [0.012, -0.041, ...],                  # 의미 임베딩 벡터
        "bm25": models.SparseVector(                    # 키워드 가중치 희소 벡터
            indices=[10421, 88210],
            values=[0.87, 0.44],
        ),
    },
    payload={"content": "문서 청크 본문 예시", "acl_open": True},
)
또한 Qdrant는 BM25 같은 키워드 검색을 위해 서버 내부에서 IDF 자동 계산을 지원합니다. Sparse 벡터 슬롯에 서버사이드 IDF 보정 옵션을 활성화하면 문서를 삽입할 때는 문서 내부 통계인 단어 빈도(TF)만 계산해 넣고, 검색 시점에는 Qdrant가 컬렉션 전체의 문서 빈도를 바탕으로 IDF를 실시간 반영합니다.
문서가 계속 추가되더라도 전체 인덱스를 다시 계산할 필요가 없다는 뜻입니다.
검색 시에는 Dense 채널과 Sparse 채널을 각각 Prefetch 단계로 미리 조회한 뒤 내장 RRF(Reciprocal Rank Fusion)로 두 순위 목록을 서버 내부에서 한 번에 융합합니다.
Tenant-aware HNSW와 양자화 옵션
멀티테넌트 환경에서는 하나의 큰 컬렉션에 여러 조직이나 공간 데이터를 함께 적재해야 할 때가 많습니다.
Qdrant는 테넌트 식별 필드(is_tenant)를 지정하고 전역 HNSW 연결(m=0)을 끈 채 테넌트별 서브 HNSW 그래프(payload_m)를 별도로 구축하는 Tenant-aware HNSW를 지원합니다.
덕분에 테넌트 필터가 걸린 질의는 다른 테넌트의 그래프 노드를 거치지 않고 자기 구역의 인덱스만 탐색합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
# 1) 전역 그래프 연결(m=0)을 끄고 테넌트별 서브 HNSW(payload_m=16) 활성화
client.create_collection(
    collection_name="shared_documents",
    vectors_config=models.VectorParams(size=1536, distance=models.Distance.COSINE),
    hnsw_config=models.HnswConfigDiff(payload_m=16, m=0),
)

# 2) 테넌트 식별 필드에 is_tenant=True 인덱스 생성
client.create_payload_index(
    collection_name="shared_documents",
    field_name="tenant_id",
    field_schema=models.KeywordIndexParams(
        type=models.KeywordIndexType.KEYWORD,
        is_tenant=True,
    ),
)

# 3) 검색 시 테넌트 필터를 걸면 해당 테넌트의 서브그래프만 탐색
results = client.query_points(
    collection_name="shared_documents",
    query=query_vector,
    query_filter=models.Filter(
        must=[models.FieldCondition(key="tenant_id", match=models.MatchValue(value="org_a"))]
    ),
    limit=10,
)
또한 대용량 데이터를 다룰 때는 벡터 차원마다 4바이트를 차지하는 float32 원형 대신 스칼라 양자화(int8)나 Binary Quantization, Product Quantization으로 메모리 사용량을 아낄 수 있습니다. 이때 디스크 기반 저장(on_disk) 옵션을 조합해 RAM에는 양자화된 벡터만 두고, 원본 벡터는 디스크 메모리 맵(mmap)에서 재채점(rescore)하는 구성도 가능합니다.
4. 후보 비교와 Qdrant를 선택한 이유
우리 RAG 시스템의 벡터 저장소는 세 단계의 비교 과정을 거쳐 Qdrant로 결정되었습니다.
초기 VectorRAG 구상: FAISS / Chroma / Milvus
초기에는 구축 난이도를 낮추기 위해 VectorRAG 도입을 검토하며 세 가지 오픈소스 벡터 DB를 비교했습니다. 먼저 FAISS는 C++ 기반으로 검색 속도가 빠르고 Python 패키지 설치만으로 바로 실행할 수 있는 장점이 있습니다. 그러나 기본 저장 방식이 인메모리라 프로세스가 종료되면 데이터가 사라지며, 메타데이터 필터링도 지원하지 않아 테스트 용도로만 사용했습니다.
반면 Chroma는 디스크 저장과 메타데이터 필터를 기본 지원해 초기 프로토타입을 구축하는 데 사용했습니다. 다만 대규모 희소 벡터 융합을 처리하기에는 한계가 있었습니다.
Milvus는 분산 서버형 아키텍처로 대규모 운영에 적합했지만 초기 인프라 구축과 운영 부담이 커서 규모에 비해 과하다고 판단하여 선택하지 않았습니다.
파일 기반 기본 스토리지: NanoVectorDB의 한계
이후 다중 문맥 추론을 위해 LightRAG를 도입하면서 처음에는 기본 내장 스토리지인 NanoVectorDB를 사용했습니다.
NanoVectorDB는 float16으로 압축한 벡터 JSON 파일을 서버 기동 시 메모리에 전부 올리는 방식이었습니다.
데이터가 누적되자 엔티티(310 MB) / 관계(289 MB) / 청크(56 MB)를 합쳐 총 27,669개 벡터만으로 RAM 655 MB를 상시 점유했습니다. 무엇보다 ANN 인덱스 없이 선형 스캔($O(N)$) 으로 동작했기 때문에 문서가 증가할수록 메모리 사용량과 검색 시간이 선형으로 늘어나는 병목이 뚜렷했습니다. 그래서 대체 DB를 찾기 시작했습니다.
전용 DB 전환: pgvector vs Qdrant
NanoVectorDB의 한계를 해결하기 위해 전용 벡터 DB로 옮길 때는 기존에 사용하던 PostgreSQL에 pgvector 확장을 붙이는 방안도 함께 검토했습니다. 기존 RDB 인스턴스를 그대로 재활용하면 추가적인 DB 배포를 하지 않아도 되기 때문입니다.
그러나 pgvector의 HNSW 인덱스는 2,000차원 상한이 걸려 있었습니다. 현재 시스템은 3,072차원 임베딩(text-embedding-3-large)을 사용하므로 pgvector에서 HNSW를 사용하려면 반정밀도(HNSW_HALFVEC)로 축소하는 방법이 필요했습니다.
반면 Qdrant는 3,072차원 벡터를 차원 제약 없이 원형 그대로 HNSW 인덱싱하며 공식 Docker 컨테이너로 즉시 기동이 가능했습니다. 여기에 더해 추후 BM25 하이브리드 검색을 도입할 때 필요한 서버사이드 IDF와 RRF 융합을 한 엔진 안에서 기본 지원한다는 점이 결정적이었습니다. 그래서 Qdrant를 선택하고, 기존 데이터를 마이그레이션해 전환했습니다.
Neo4j: 아키텍처와 핵심 기능 및 선정 이유
Neo4j는 데이터를 관계형 테이블이나 문서 형태가 아니라 그래프 구조 자체를 저장하는 그래프 데이터베이스입니다.
1. Labeled Property Graph 모델
Neo4j는 속성 그래프(Labeled Property Graph) 모델을 따릅니다.
-
노드: 독립적인 개체를 표현합니다. 하나 이상의 라벨을 붙여 역할을 분류하며 내부에 Key-Value 형태의 속성을 저장합니다.
-
관계: 노드 사이의 연결을 객체로 저장합니다. 모든 관계는 반드시 하나의 타입과 방향을 가지며, 관계 자체에도 가중치나 설명 같은 속성을 저장합니다. 관계형 DB에서 다대다 관계를 표현하기 위해 중간 조인 테이블을 두는 것과 달리 그래프 구조가 스키마에 그대로 반영됩니다.
2. 핵심 저장 엔진과 기능
Index-Free Adjacency
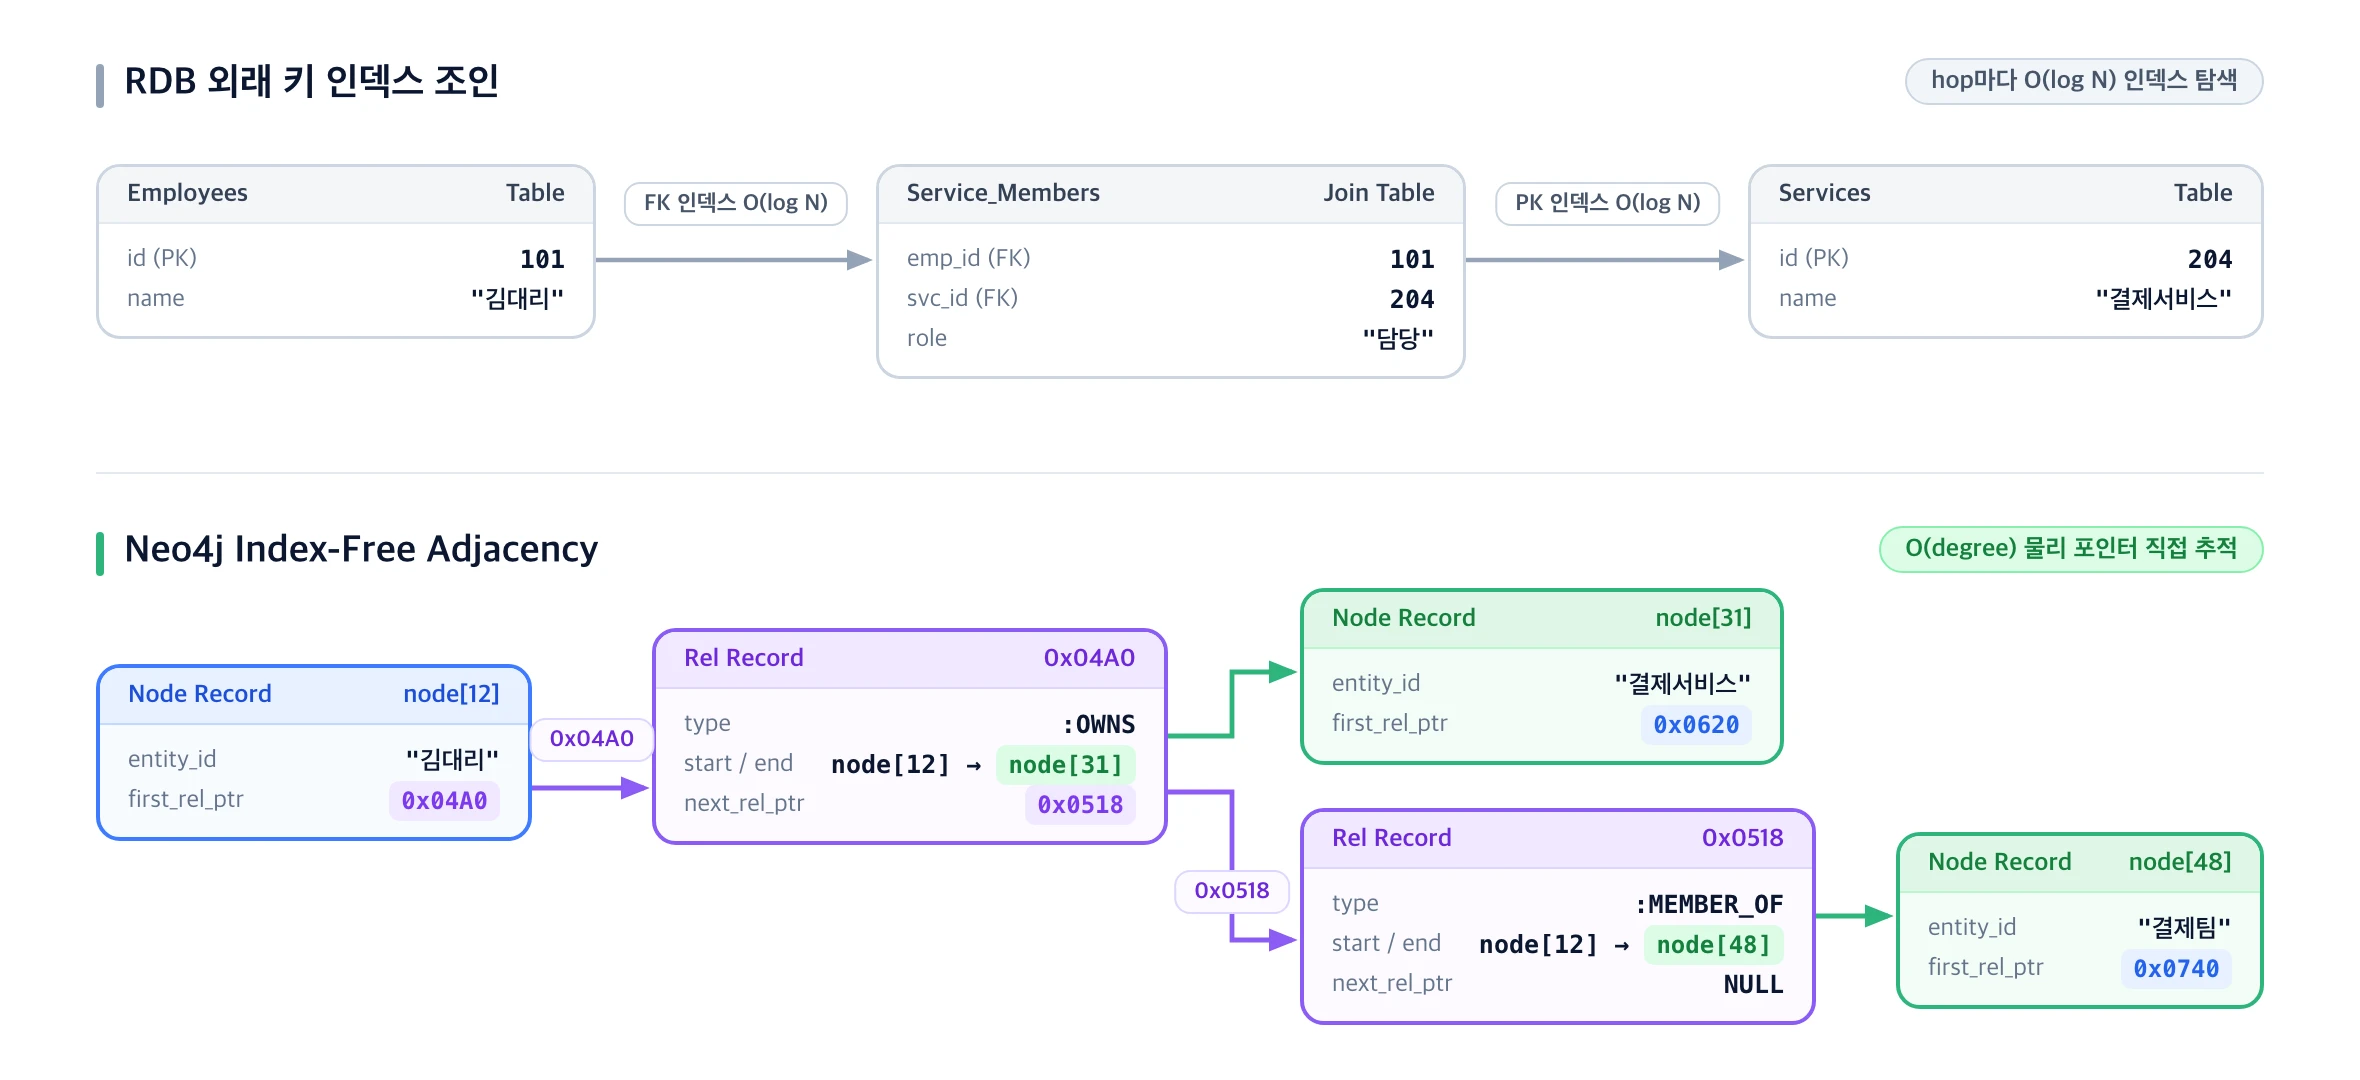
Neo4j가 관계 탐색에서 강력한 이유의 핵심은 Index-Free Adjacency 구조입니다. 관계형 데이터베이스나 일반 키-값 저장소에서 A 노드와 연결된 B 노드들을 찾으려면 외래 키 인덱스를 탐색하는 $O(\log N)$ 조회를 연결 횟수마다 반복해야 합니다. 전체 데이터 크기($N$)가 커질수록 조인 비용도 함께 무거워집니다.
반면 Neo4j는 저장소 파일 내부에서 각 노드 레코드가 자신에게 연결된 첫 번째 관계 레코드의 물리적 위치 포인터를 직접 가리키고, 관계 레코드 역시 시작/끝 노드와 다음 관계의 포인터를 직접 보유합니다. 따라서 이웃 노드를 따라가는 비용은 전체 그래프의 규모와 무관하게 오직 해당 노드에 연결된 간선 수(차수) 에만 비례합니다. 그래서 1-hop이나 다중 홉 탐색에서 일관된 응답 속도를 유지할 수 있습니다.
Cypher 쿼리 언어와 일괄 트랜잭션 처리
Neo4j는 그래프 패턴을 텍스트로 표현하는 선언적 쿼리 언어 Cypher를 사용합니다.
MATCH (a)-[:DIRECTED]-(b) 같은 직관적인 패턴 매칭은 물론 UNWIND 구문을 결합하면 수백개의 노드와 관계를 루프 없이 단일 트랜잭션 안에서 한 번에 병합(MERGE)하고 속성을 갱신할 수 있습니다.
스키마 B-Tree 인덱스와 Lucene 풀텍스트 인덱스
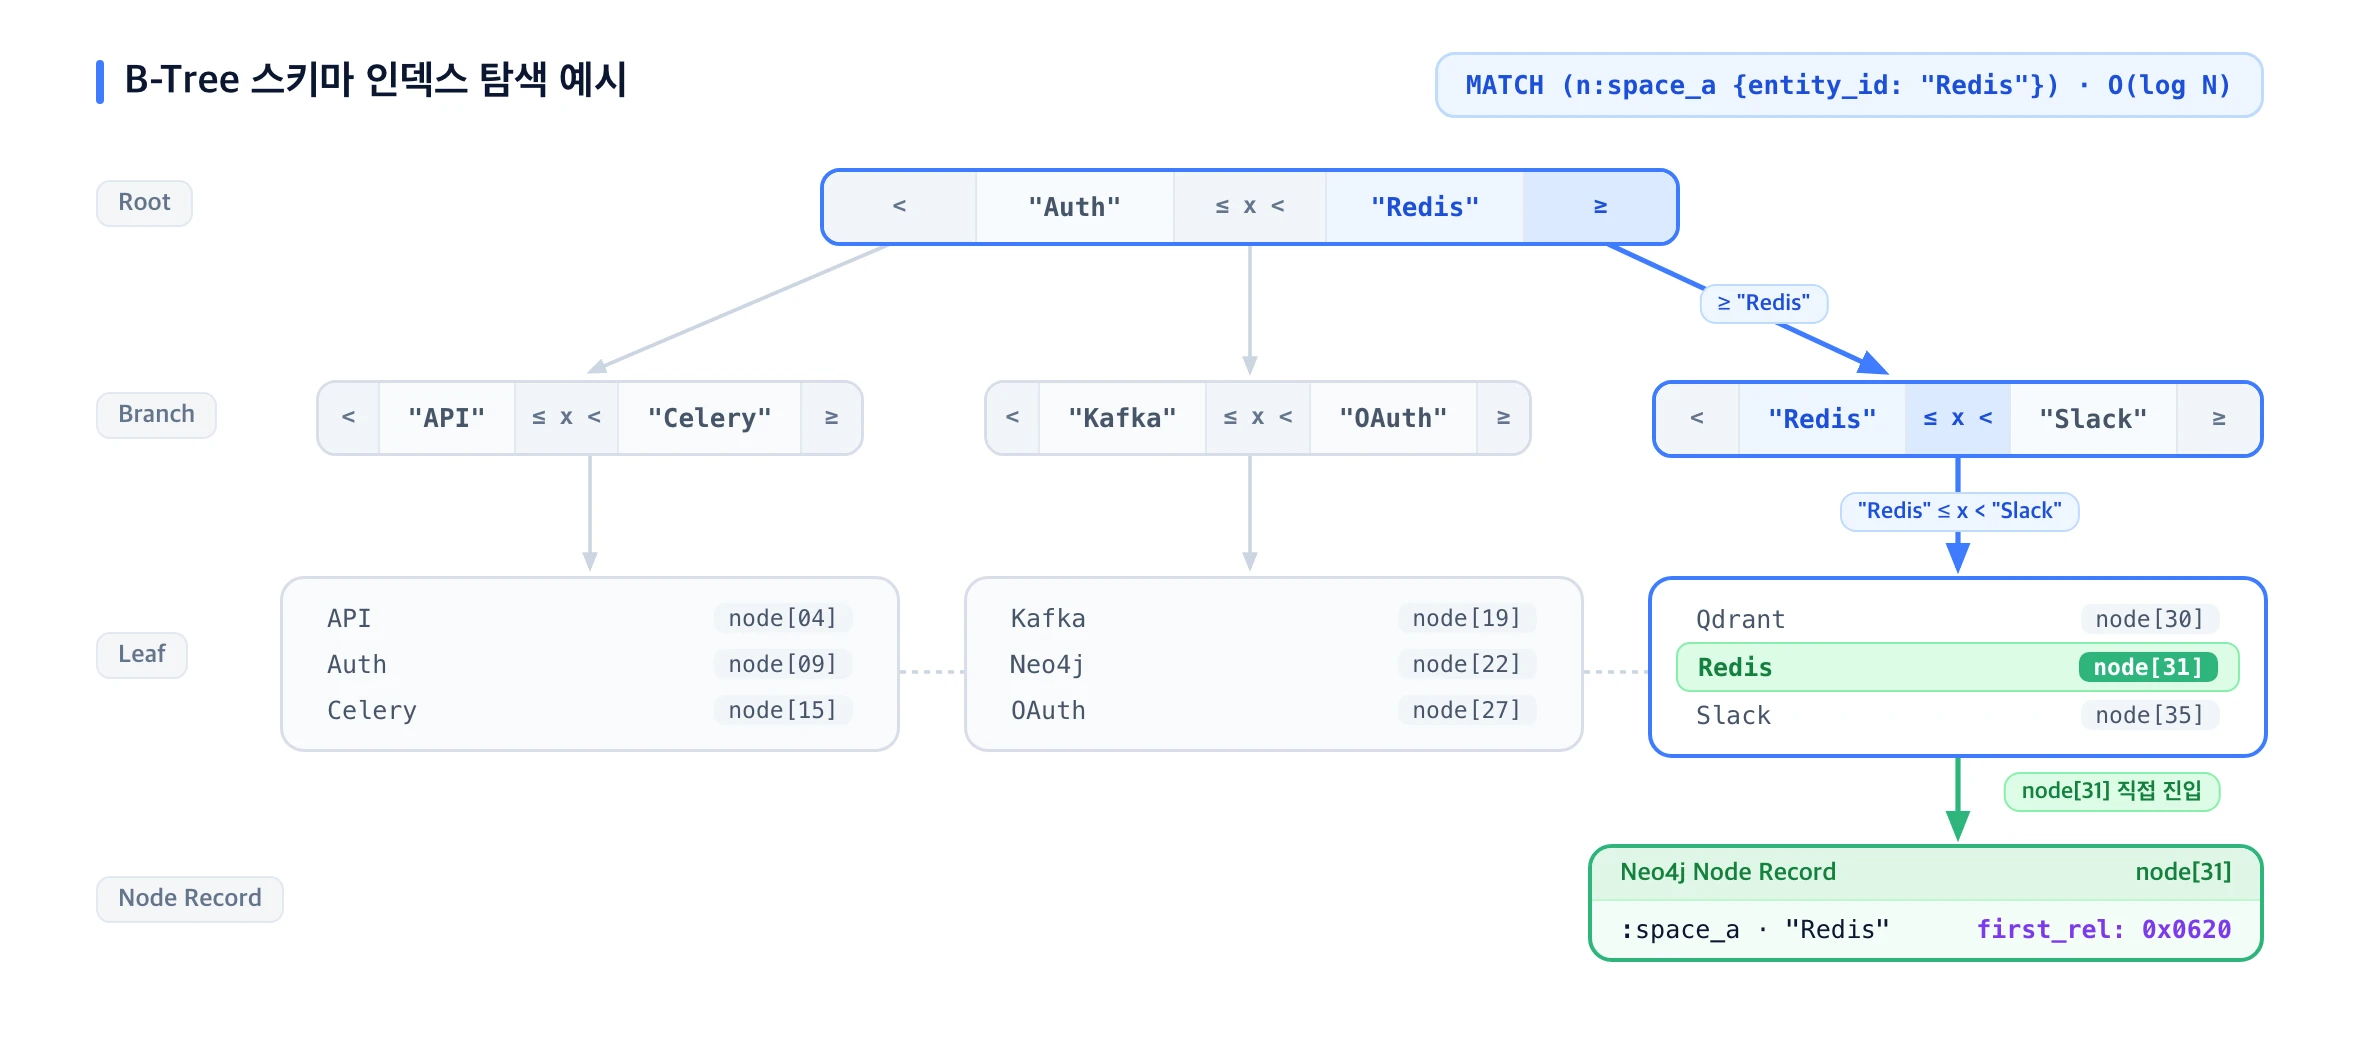
그래프 탐색 자체는 포인터를 따라가지만 탐색을 시작할 첫 노드(예: 특정 이름을 가진 엔티티)를 찾을 때는 인덱스가 필요합니다. Neo4j는 라벨과 속성 조합에 B-Tree 인덱스를 걸어 정확한 키 매칭을 $O(\log N)$으로 검색합니다.
이와 별도로 Apache Lucene 기반의 풀텍스트 인덱스를 내장해 N-gram 검색을 지원합니다. 이는 부분 일치, 토큰 검색을 처리하는데 사용되고, cjk 분석기를 지정하면 한국어나 한자 및 일본어가 섞인 엔티티 이름도 형태 단위 N-gram으로 토큰화해 검색할 수 있습니다. 풀텍스트 인덱스는 쓰기 트랜잭션 직후 비동기로 반영하여 쓰기 속도를 높이는 (eventually_consistent) 모드로 지원하는데, 대신 잠깐의 시간동안 다른 검색 결과가 나올 수 있는 문제가 있습니다.
APOC 확장 라이브러리
Neo4j는 APOC(Awesome Procedures on Cypher) 플러그인으로 기본 Cypher 문법만으로 작성하기 까다로운 그래프 탐색과 배치 처리를 프로시저로 지원합니다. 대표적으로 깊이 제한/라벨 필터/최대 노드 상한을 걸어 너비 우선 탐색(BFS)이나 깊이 우선 탐색(DFS), 서브그래프를 추출하는 절차를 단일 쿼리 호출로 실행할 수 있습니다.
3. 후보 비교와 Neo4j를 선택한 이유
그래프 저장소 역시 LightRAG 기본 파일 스토리지에서 운영 DB로 전환하면서 두 차례의 기술 검토를 거쳤습니다.
파일 기반 기본 스토리지: NetworkX의 한계
LightRAG는 기본 그래프 저장소로 Python 라이브러리인 NetworkX를 사용합니다. NetworkX는 전체 그래프를 GraphML 파일에 보관했다가 서버가 시작될 때 전부 RAM에 올리고 Python 딕셔너리를 순회하며 탐색합니다.
이 방식은 전용 그래프 쿼리 엔진이 없을 뿐 아니라 파일 락에 의존하므로 멀티프로세스 환경에서 동시 쓰기가 불가능했습니다. 또한 작업이 완전히 끝난 시점에만 파일에 한꺼번에 기록하므로 인덱싱 도중 프로세스가 비정상 종료되면 변경분이 사라지는 문제가 있었고, 실제로 몇 번 경험하며 데이터를 수동으로 복구하기도 했습니다.
전용 DB 전환: Apache AGE vs Neo4j
파일 스토리지를 대체할 후보로 PostgreSQL 위에서 동작하는 그래프 확장인 Apache AGE와 네이티브 그래프 DB인 Neo4j를 비교했습니다. Apache AGE를 선택하면 기존 RDB 인스턴스에 그래프 기능을 통합해 추가적인 DB 컨테이너가 필요하지 않았습니다. 그러나 확장 모듈을 별도로 빌드해 호환성을 관리해야 하는 부담이 크고, 실제 애플리케이션 코드에서는 SQL과 Cypher 문법을 섞어 작성해야하는 문제가 있었습니다.
반면 Neo4j는 공식 Docker 이미지(neo4j:5)와 APOC 플러그인 설정만으로 바로 실행 환경을 만들 수 있었습니다. 무엇보다 Cypher 일괄 배치 처리와 CJK 풀텍스트 인덱스 및 APOC BFS 탐색을 네이티브 기능으로 바로 활용하므로 운영 전환 비용이 더 낮다고 판단해 최종 채택했습니다.
내 RAG 시스템에 적용하고 활용한 기능
설계만 참고한 기능이 아니라 실제 코드에 구현해 운영 중인 기능들입니다.
Qdrant에서 활용한 기능
1. Dense + BM25 Sparse 하이브리드와 서버사이드 IDF 융합
문서 청크 컬렉션에는 Named Vectors 스키마를 적용해 3,072차원 코사인 유사도 벡터와 BM25 희소 벡터를 한 포인트에 함께 저장했습니다. 한국어 조사 변화/영문 약어/숫자를 모두 탐색하기 위해 인덱싱과 질의 모두 Kiwi 토크나이저(형태소 명사 / 바이그램 / 영문과 숫자 / 문자 3-gram 해시)로 TF 가중치를 계산합니다. 역문서빈도 계산은 Qdrant의 IDF 옵션에 맡겼습니다. 이 방식 덕분에 사내 위키나 대화가 실시간으로 계속 추가되어도 전체 코퍼스의 문서 빈도(DF) 통계를 주기적으로 재계산해 모든 포인트를 덮어쓸 필요가 없습니다. 검색 시에는 Dense 채널과 BM25 채널을 각각 미리 추출한 뒤 Qdrant 내장 RRF로 최종 순위를 산출합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# 청크 컬렉션 스키마 및 하이브리드 검색 구조 예시
client.create_collection(
    collection_name="rag_chunks_ws_space_a",
    vectors_config={"dense": models.VectorParams(size=3072, distance=models.Distance.COSINE)},
    sparse_vectors_config={"bm25": models.SparseVectorParams(modifier=models.Modifier.IDF)},
    hnsw_config=models.HnswConfigDiff(payload_m=16, m=0),
)

results = await aclient.query_points(
    collection_name="rag_chunks_ws_space_a",
    prefetch=[
        models.Prefetch(query=dense_vec, using="dense", limit=top_k * 3, filter=acl_filter, score_threshold=0.2),
        models.Prefetch(query=sparse_vec, using="bm25", limit=top_k * 3, filter=acl_filter),
    ],
    query=models.FusionQuery(fusion=models.Fusion.RRF),
    limit=top_k,
)
2. 용도에 따른 하이브리드 멀티테넌시 분리
처음에는 모든 워크스페이스가 하나의 청크 컬렉션을 공유하고 페이로드 필터로만 나누었습니다. 그러나 Qdrant의 서버사이드 IDF는 컬렉션별 단위 통계로 계산되므로 서로 다른 성격의 문서 공간(예: 위키 / 대화 노트)을 한 컬렉션에 두면 한쪽의 단어 빈도가 다른 쪽의 BM25 점수에 영향을 주는 IDF 통계 누수가 발생합니다. 사용자 사전을 갱신할 때도 다른 워크스페이스 청크까지 함께 재토큰화되는 문제가 있었습니다.
이 문제를 해결하기 위해 컬렉션 성격에 따라 격리 전략을 나눴습니다.
-
청크 컬렉션: 워크스페이스별로 물리 컬렉션 분리를 적용해 IDF 통계와 희소 벡터 리프레시를 완전히 독립시켰습니다.
-
엔티티와 관계 컬렉션: Dense 벡터만 사용하므로 같은 컬렉션을 공유하되 워크스페이스 키에 테넌트 기능을 이용해 논리 격리했습니다. 요청마다 컨텍스트 변수가 현재 대상 워크스페이스를 지정합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
# 1) 청크는 물리 컬렉션 분리, 엔티티와 관계는 단일 컬렉션 공유
def get_collection_name(namespace: str, workspace: str) -> str:
    if namespace == "chunks":
        return f"rag_{namespace}_ws_{workspace}"
    return f"rag_{namespace}"

# 2) 공유 컬렉션에서는 Tenant-aware HNSW로 워크스페이스별 서브그래프 분리
client.create_collection(
    collection_name="rag_entities",
    vectors_config=models.VectorParams(size=3072, distance=models.Distance.COSINE),
    hnsw_config=models.HnswConfigDiff(payload_m=16, m=0),
)
client.create_payload_index(
    collection_name="rag_entities",
    field_name="workspace_id",
    field_schema=models.KeywordIndexParams(
        type=models.KeywordIndexType.KEYWORD,
        is_tenant=True,
    ),
)
3. 페이로드 인덱스를 활용한 접근 권한(ACL)
문서 권한은 공개 여부(Bool)와 허용 그룹/사용자(Keyword 배열)에 페이로드 인덱스를 걸어 검색 시 HNSW 탐색과 동시에 필터링합니다. 그리고 Neo4j 그래프 탐색 경로에서 추출된 근거 청크 ID는 마지막 단계에서 Qdrant의 ID 목록 조건과 ACL 조건을 함께 건 스크롤 조회로 한 번 더 검증해 비공개 문서 유출을 차단합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
# 1) 검색 시 HNSW 탐색과 함께 적용할 OR 조건(공개 OR 허용 그룹 OR 허용 사용자)
acl_filter = models.Filter(
    should=[
        models.FieldCondition(key="acl_open", match=models.MatchValue(value=True)),
        models.FieldCondition(key="acl_view_groups", match=models.MatchAny(any=user_groups)),
        models.FieldCondition(key="acl_view_users", match=models.MatchAny(any=[user_id])),
    ]
)

# 2) Neo4j 탐색에서 추출된 근거 청크 ID에 대한 2차 ACL 검증
points, _ = await aclient.scroll(
    collection_name="rag_chunks_ws_space_a",
    scroll_filter=models.Filter(
        must=[
            models.HasIdCondition(has_id=candidate_point_ids),
            acl_filter,
        ]
    ),
    limit=len(candidate_point_ids),
    with_payload=True,
    with_vectors=False,
)
Neo4j에서 활용한 기능
1. 라벨 기반 논리 격리와 스키마 및 CJK 풀텍스트 인덱스
Neo4j Community Edition의 단일 데이터베이스 제약이 있습니다. 그래서 여러 워크스페이스를 격리하기 위해 모든 노드 조회와 생성 쿼리에 요청 컨텍스트의 워크스페이스 라벨을 부여합니다. 기동 시 워크스페이스 라벨마다 노드 식별자와 공개 여부 속성에 각각 B-Tree 인덱스를 자동 생성하고, 이름 부분 검색을 위해 CJK 분석기가 설정된 풀텍스트 인덱스를 함께 생성합니다.
1
2
3
4
5
6
7
8
9
10
11
-- 워크스페이스별 B-Tree 및 CJK 풀텍스트 인덱스 구성 예시
CREATE INDEX IF NOT EXISTS FOR (n:`space_a`) ON (n.entity_id);
CREATE INDEX IF NOT EXISTS FOR (n:`space_a`) ON (n.acl_open);
CREATE FULLTEXT INDEX entity_id_fulltext_idx_space_a IF NOT EXISTS
FOR (n:`space_a`) ON EACH [n.entity_id]
OPTIONS {
  indexConfig: {
    `fulltext.analyzer`: 'cjk',
    `fulltext.eventually_consistent`: true
  }
};
엔티티 이름 검색을 호출할 때는 풀텍스트 점수를 기준으로 완전 일치(+1,000)와 접두사 일치(+500) 보너스를 더해 정렬합니다. 이때 특수문자 등으로 풀텍스트 쿼리 파싱이 실패할 때는 부분 문자열(CONTAINS) 스캔으로 안전하게 폴백합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
-- CJK 풀텍스트 검색 + 완전 일치(+1,000) 및 접두사 일치(+500) 보너스 정렬
CALL db.index.fulltext.queryNodes($index_name, $search_query) YIELD node, score
WHERE node:`space_a`
  AND (node.acl_open = true OR any(g IN $acl_groups WHERE g IN coalesce(node.acl_view_groups, [])))
WITH node.entity_id AS label, toLower(node.entity_id) AS label_lower, score
WITH label,
     CASE
         WHEN label_lower = $query_lower THEN score + 1000
         WHEN label_lower STARTS WITH $query_lower THEN score + 500
         ELSE score
     END AS final_score
ORDER BY final_score DESC, label ASC
LIMIT $limit
RETURN label;
2. 일괄 배치 처리와 비동기 병렬 차수 조회
그래프 인덱싱과 질의 시 네트워크 왕복을 줄이기 위해 노드와 엣지의 일괄 upsert 및 조회를 모두 Cypher 일괄 병합 구문으로 묶어 단일 트랜잭션으로 실행합니다. 검색 단계에서는 노드 속성 배치 조회와 노드 차수 배치 조회를 비동기로 동시 실행해 응답 시간을 줄였으며, 읽기 경로에는 지수 백오프 기반 3회 재시도를 적용했습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 1) 일괄 upsert를 위한 Cypher UNWIND 단일 트랜잭션 병합
query = """
UNWIND $nodes AS row
MERGE (n:`space_a` {entity_id: row.entity_id})
SET n += row.props
"""

# 2) 읽기 경로 지수 백오프 3회 재시도 + 속성 및 차수 배치 동시 조회
READ_RETRY = retry(
    stop=stop_after_attempt(3),
    wait=wait_exponential(multiplier=1, min=4, max=10),
    retry=retry_if_exception_type(READ_RETRY_EXCEPTIONS),
)

nodes_dict, degrees_dict = await asyncio.gather(
    graph.get_nodes_batch(node_ids),
    graph.node_degrees_batch(node_ids),
)
3. APOC BFS 서브그래프 추출과 엔티티 차수 기반 병합
특정 엔티티를 중심으로 그래프 구조를 한 번에 추출해야 하는 그래프 시각화 및 탐색 API에서는 APOC 확장 라이브러리의 BFS 서브그래프 추출 프로시저로 깊이 제한과 최대 노드 수 상한을 지켜 서브그래프를 추출합니다. APOC 호출이 실패하는 예외 상황에서는 Cypher 1-hop 조회와 Python 큐 기반 BFS 폴백 경로로 동작합니다.
그리고 RAG 6편에서 다룬 것처럼 인덱싱 모델을 교체하는 과정에서 같은 개념이 대소문자나 띄어쓰기 차이로 별개 노드로 쪼개지는 엔티티 표기 분열 문제가 누적되었습니다. 이 노드들을 병합할 때도 Neo4j의 연결 차수 조회 쿼리를 활용해 가장 많은 관계를 가진 노드를 대표 노드로 선별하고 나머지 노드의 관계와 설명을 병합했습니다.
1
2
3
4
5
6
7
8
9
10
11
12
-- APOC BFS 서브그래프 추출 및 연결 차수 조회 패턴 예시
CALL apoc.path.subgraphAll(start, {
  labelFilter: '+space_a',
  maxLevel: 3,
  limit: 1000,
  bfs: true
}) YIELD nodes, relationships
RETURN nodes, relationships;

MATCH (n:`space_a`)
WHERE n.entity_id IN $candidates
RETURN n.entity_id AS entity_id, COUNT { (n)--() } AS degree;
4. Cypher 동적 ACL 필터와 합집합 권한 전략
Neo4j에서 1-hop 확장할 때는 쿼리 조건절에 동적으로 ACL 조건식을 붙여 비공개 노드를 탐색하지 않도록 차단합니다.
1
2
3
4
5
6
7
8
9
10
11
12
-- 1-hop 이웃 탐색 시 워크스페이스 라벨과 ACL 조건을 함께 적용하는 패턴
UNWIND $node_ids AS id
MATCH (n:`space_a` {entity_id: id})
WHERE (n.acl_open = true
   OR any(g IN $acl_groups WHERE g IN coalesce(n.acl_view_groups, []))
   OR $acl_user IN coalesce(n.acl_view_users, []))
OPTIONAL MATCH (n)-[r]-(connected:`space_a`)
WHERE connected IS NULL
   OR (connected.acl_open = true
   OR any(g IN $acl_groups WHERE g IN coalesce(connected.acl_view_groups, []))
   OR $acl_user IN coalesce(connected.acl_view_users, []))
RETURN id AS queried_id, n.entity_id AS node_entity_id, connected.entity_id AS connected_entity_id
특히 LightRAG에서는 여러 문서에서 추출된 정보가 하나의 엔티티 노드로 병합되므로 권한 관련 문제가 발생하기 쉽습니다. 실제로 초기에는 해당 엔티티가 포함된 문서 권한의 교집합을 저장했다가 공개 문서만 볼 수 있는 사용자까지 차단되는(false block) 문제를 겪었습니다. 이를 해결하기 위해 엔티티와 관계에는 포함된 모든 문서 권한의 합집합을 기록해 공개 문서 사용자의 진입을 허용하고, 최종적인 청크 접근 제어는 Qdrant의 접근 페이로드를 활용해 엄격하게 필터링하도록 역할을 분담했습니다.
트러블슈팅
Qdrant와 Neo4j를 실제 서비스에 적용한 뒤 운영 과정에서 발생한 장애와 해결 방안을 정리해 보고자 합니다.
1. Copy-on-Write에 의한 디스크 고갈 장애
운영 중 Qdrant 스토리지 디스크가 급격히 고갈되는 장애가 발생한 적이 있습니다. 원인은 30분마다 실행되는 전체 권한 동기화 작업이 변경 여부를 확인하지 않고 약 25만 개 포인트(약 3 GB)를 매번 페이로드 부분 갱신 API 호출했기 때문입니다.
앞에서 설명한 Qdrant의 Copy-on-Write 특성상 메타데이터만 갱신해도 3,072차원 벡터까지 함께 새 세그먼트에 복제되면서 세그먼트 정리가 회차 주기를 따라가지 못했습니다.
이를 해결하기 위해 권한 일괄 갱신 시점에 권한을 비교하고, 업데이트가 필요한 최소한의 페이로드 필드만 읽어 변경된 포인트에만 쓰기를 수행하도록 수정했습니다.
그 결과 불필요한 디스크 재기록(258,217건 → 0건)과 페이로드 읽기량(190 MB → 37 MB)을 대폭 줄였습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 벡터와 본문은 제외하고 권한 비교에 필요한 최소 페이로드 필드만 조회
points, offset = client.scroll(
    collection_name="rag_chunks_ws_space_a",
    with_payload=["full_doc_id", "acl_open", "acl_view_groups", "acl_view_users"],
    with_vectors=False,
    limit=256,
    offset=offset,
)

# 기존 권한과 달라진 포인트만 추려 set_payload 호출
changed_ids = [p.id for p in points if not acl_matches(p.payload, target_acl)]
if changed_ids:
    client.set_payload(
        collection_name="rag_chunks_ws_space_a",
        payload=target_acl,
        points=changed_ids,
        wait=True,
    )
정리
오늘은 RAG 시스템에서 왜 Qdrant와 Neo4j를 선택하고, 어떻게 활용하고 있는지 정리해봤습니다. 청크 단위의 의미 유사도 탐색/BM25 희소 키워드 결합 및 권한 필터링은 Qdrant가 담당하고, 여러 문서에 분산된 개념들이 어떻게 연결되어 있는지 구조적으로 묶고 탐색하는 일은 Neo4j가 담당합니다.
다음 글에서는 기존 시리즈 흐름으로 돌아와 비정형 대화가 주인 메신저 데이터를 원문 대신 지식 노트로 증류해 RAG에 인덱싱한 과정을 정리하겠습니다.